Processus de développement multi-IA piloté par la documentation dans Naia ADK : tester l'efficacité avec Jev
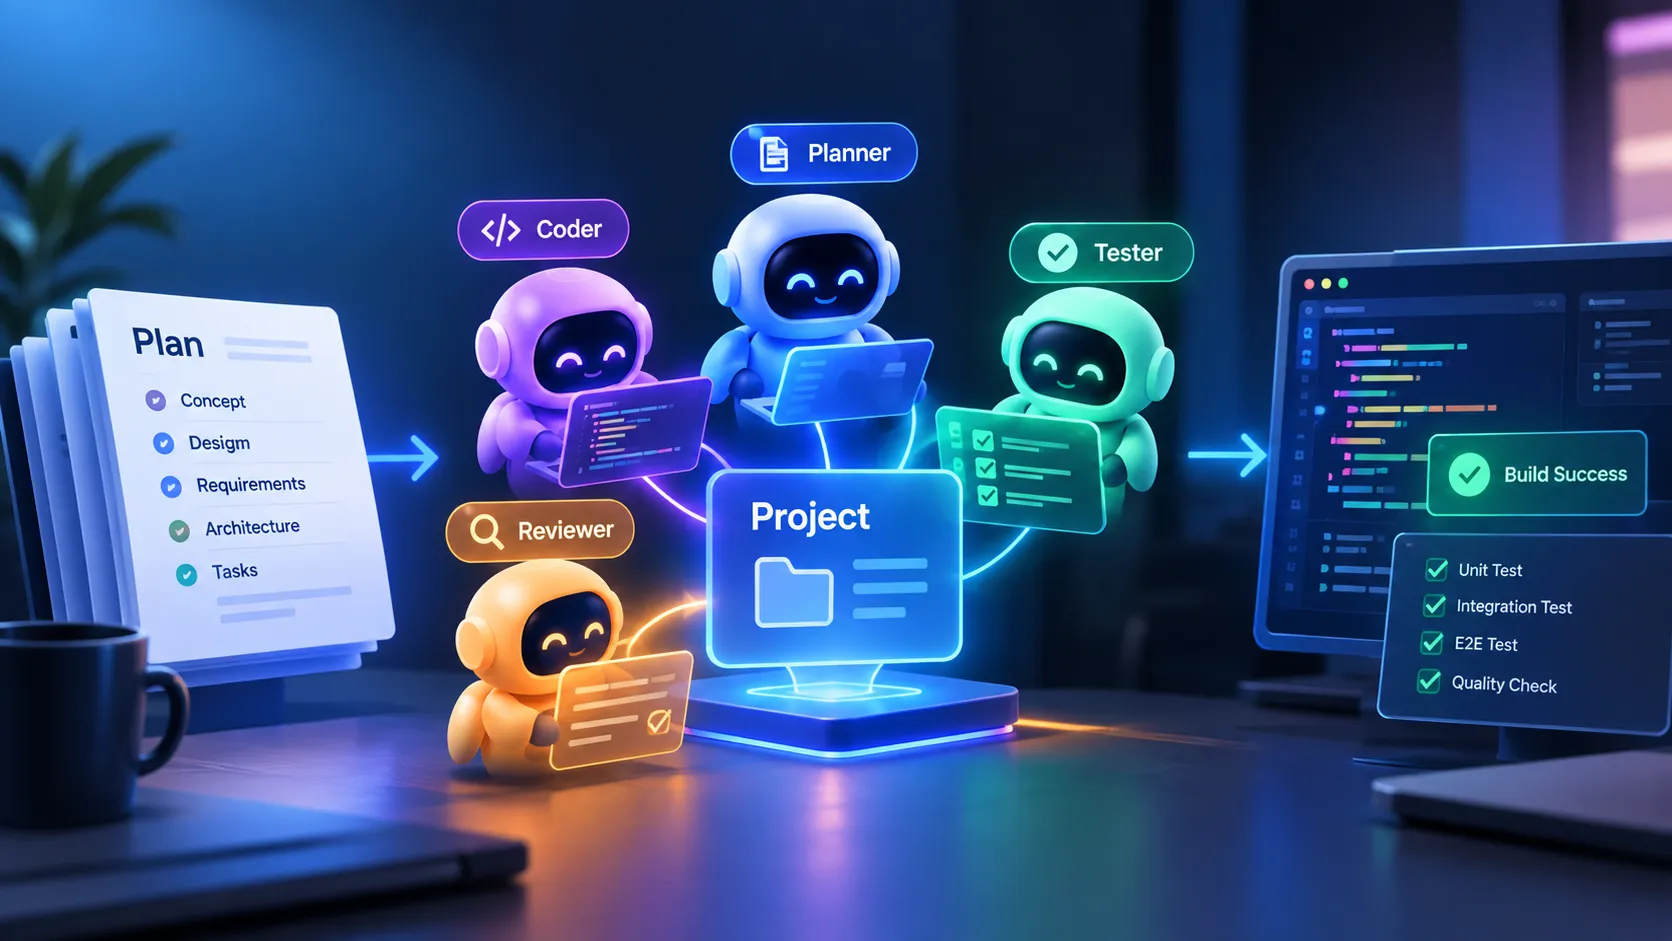 Bonjour. Je suis Luke, le créateur de Naia.
Naia peut ressembler à un produit grand public d'agents de personnages, mais une grande partie de mon travail quotidien consiste en du développement logiciel. Nous construisons donc l'infrastructure de développement correspondante et menons le développement logiciel pour des clients entreprises en utilisant l'infrastructure de développement de Naia. Par le passé, j'ai publié un ouvrage intitulé « Harness Engineering : le génie logiciel IA à partir de Re:Zero » (édition coréenne, édition anglaise). Depuis lors, nous continuons à déployer d'importants efforts pour structurer au mieux un processus de développement fondé sur des agents IA.
Aujourd'hui, je partage le processus de développement logiciel et les livrables conçus pour Naia, ainsi que la manière dont nous tentons d'introduire Jev, un modèle de décision actuellement très en vue, dans ce processus de développement.
Dans ce processus de développement, je cherchais à atteindre 3 objectifs : la visibilité, la parallélisation et l'optimisation des coûts.
- Visibilité : Savoir si le développement avance correctement et, en cas de dérive du modèle, identifier à quelle étape le problème est survenu.
- Parallélisation : Répartir les tâches en parallèle entre plusieurs agents pour accélérer la vitesse de développement.
- Optimisation des coûts : Utiliser des modèles aux coûts optimisés. Jev constitue ici une excellente alternative.
Le cadre de base du système de règles d'exploitation (Harness) est mis à disposition en open source ci-dessous :
- Cadre de base de l'espace de travail personnel et système de règles d'exploitation (Harness) : nextain/naia-adk
- Cadre de base pour la collaboration d'équipe et de projet : nextain/naia-pj-adk
- Guide de participation communautaire : nextain/naia-comm-public
- Jev est un modèle de décision publié par TypeSafe AI.
La file de tâches, le tableau de bord, le runner et les documents de planification décrits dans cet article sont encore en cours de développement interne et restent donc privés. Actuellement, ce processus se trouve également en phase de validation pour une nouvelle fonctionnalité à venir sur le Web de Naia : le développement de Naia Visual Agent Studio, un avatar vidéo capable de synchronisation labiale et de chant. S'ils ne sont pas encore rendus publics, c'est parce qu'ils ne sont pas encore assez aboutis pour un usage partagé en équipe ; nous les publierons dès qu'ils seront finalisés.
Abréviations utilisées dans cet article et nos documents de développement
Tout d'abord, nos documents de développement, tickets et files de tâches utilisent les abréviations ci-dessous et disposent d'un lexique standard de projet. C'est parce que je ne voulais pas taper de longues instructions à l'IA et pour éviter tout risque de confusion terminologique.
| Abréviation | Nom complet | Terme | Définition en une ligne |
|---|---|---|---|
| PC | Product / Project Concept | Planification de haut niveau | Pourquoi nous construisons. L'essence du produit, sa raison d'être, sa valeur utilisateur, son architecture globale de l'information |
| SP | Screen Plan | Planification d'écrans | Plan structurel des écrans que l'utilisateur verra (mise en page, disposition, navigation) |
| UC | User Scenario | Parcours utilisateur (Scénario utilisateur) | Le parcours complet par lequel l'utilisateur entre dans un contexte donné, atteint son objectif et repart |
| RQ | Requirements | Exigences | Conditions et critères d'acceptation mesurables que le système doit remplir pour satisfaire UC et SP |
| PL | Plan / Architecture | Analyse technique et plan de conception | Confirmer les réalités techniques par des mesures réelles et établir l'architecture et les plans de mise en œuvre par étapes |
| FE | FEature | Spécification fonctionnelle | Unités fonctionnelles concrètes créées pour réaliser UC et RQ. Ce n'est pas le Frontend |
| UT | Unit Test | Test unitaire | Valider qu'une unité fonctionnelle fonctionne conformément aux spécifications |
| IT | Integration Test | Test d'intégration | Test traversant les composants réels du backend de bout en bout sans interface. Ce n'est pas la technologie de l'information (IT) |
| E2E | End-to-End Test | Test de parcours utilisateur de bout en bout | Test traversant un parcours utilisateur complet de l'écran réel jusqu'au backend réel |
| QC | Quality Control / Validation | Validation indépendante | Vérifier agressivement les promesses du produit uniquement avec PC et SP, sans regarder le scénario du développeur ni l'implémentation interne |
1. Contexte d'introduction et prise de conscience des problèmes
Si l'on confie largement le développement à des agents IA, ils ont tendance à concevoir directement l'interface utilisateur (UI, User Interface) sans backend, ou à déclarer réussis des tests exécutés avec des objets fictifs (mocks). C'est pourquoi nous procédons avec une planification descendante (Top-down) et un développement ascendant (Bottom-up). La planification découle de l'expérience utilisateur globale, tandis que le développement part de la plus petite unité fonctionnelle, en n'attachant l'interface qu'après que le backend a été réellement traversé. Commencer par l'interface expose en effet à un risque élevé de remaniements massifs lors de l'intégration.
2. Flux de travail piloté par la documentation et processus de développement
Rédiger les documents en premier sert à verrouiller à l'avance le périmètre et les critères d'acceptation. En documentant les exigences plutôt qu'en formulant de simples invites (prompts), on peut remonter à la cause fondamentale en cas de problème.
Nous déroulons l'ensemble des documents du processus de développement sous forme de liste, et après validation humaine, nous créons les tickets et les éléments de la file de tâches. Avant de créer un nouveau ticket, l'IA vérifie à quels documents ce ticket se rattache et examine les tickets précédemment ouverts. Ce n'est que lorsque tickets, files et reçus de tests sont tous dûment réunis que l'achèvement de la mission peut être validé.
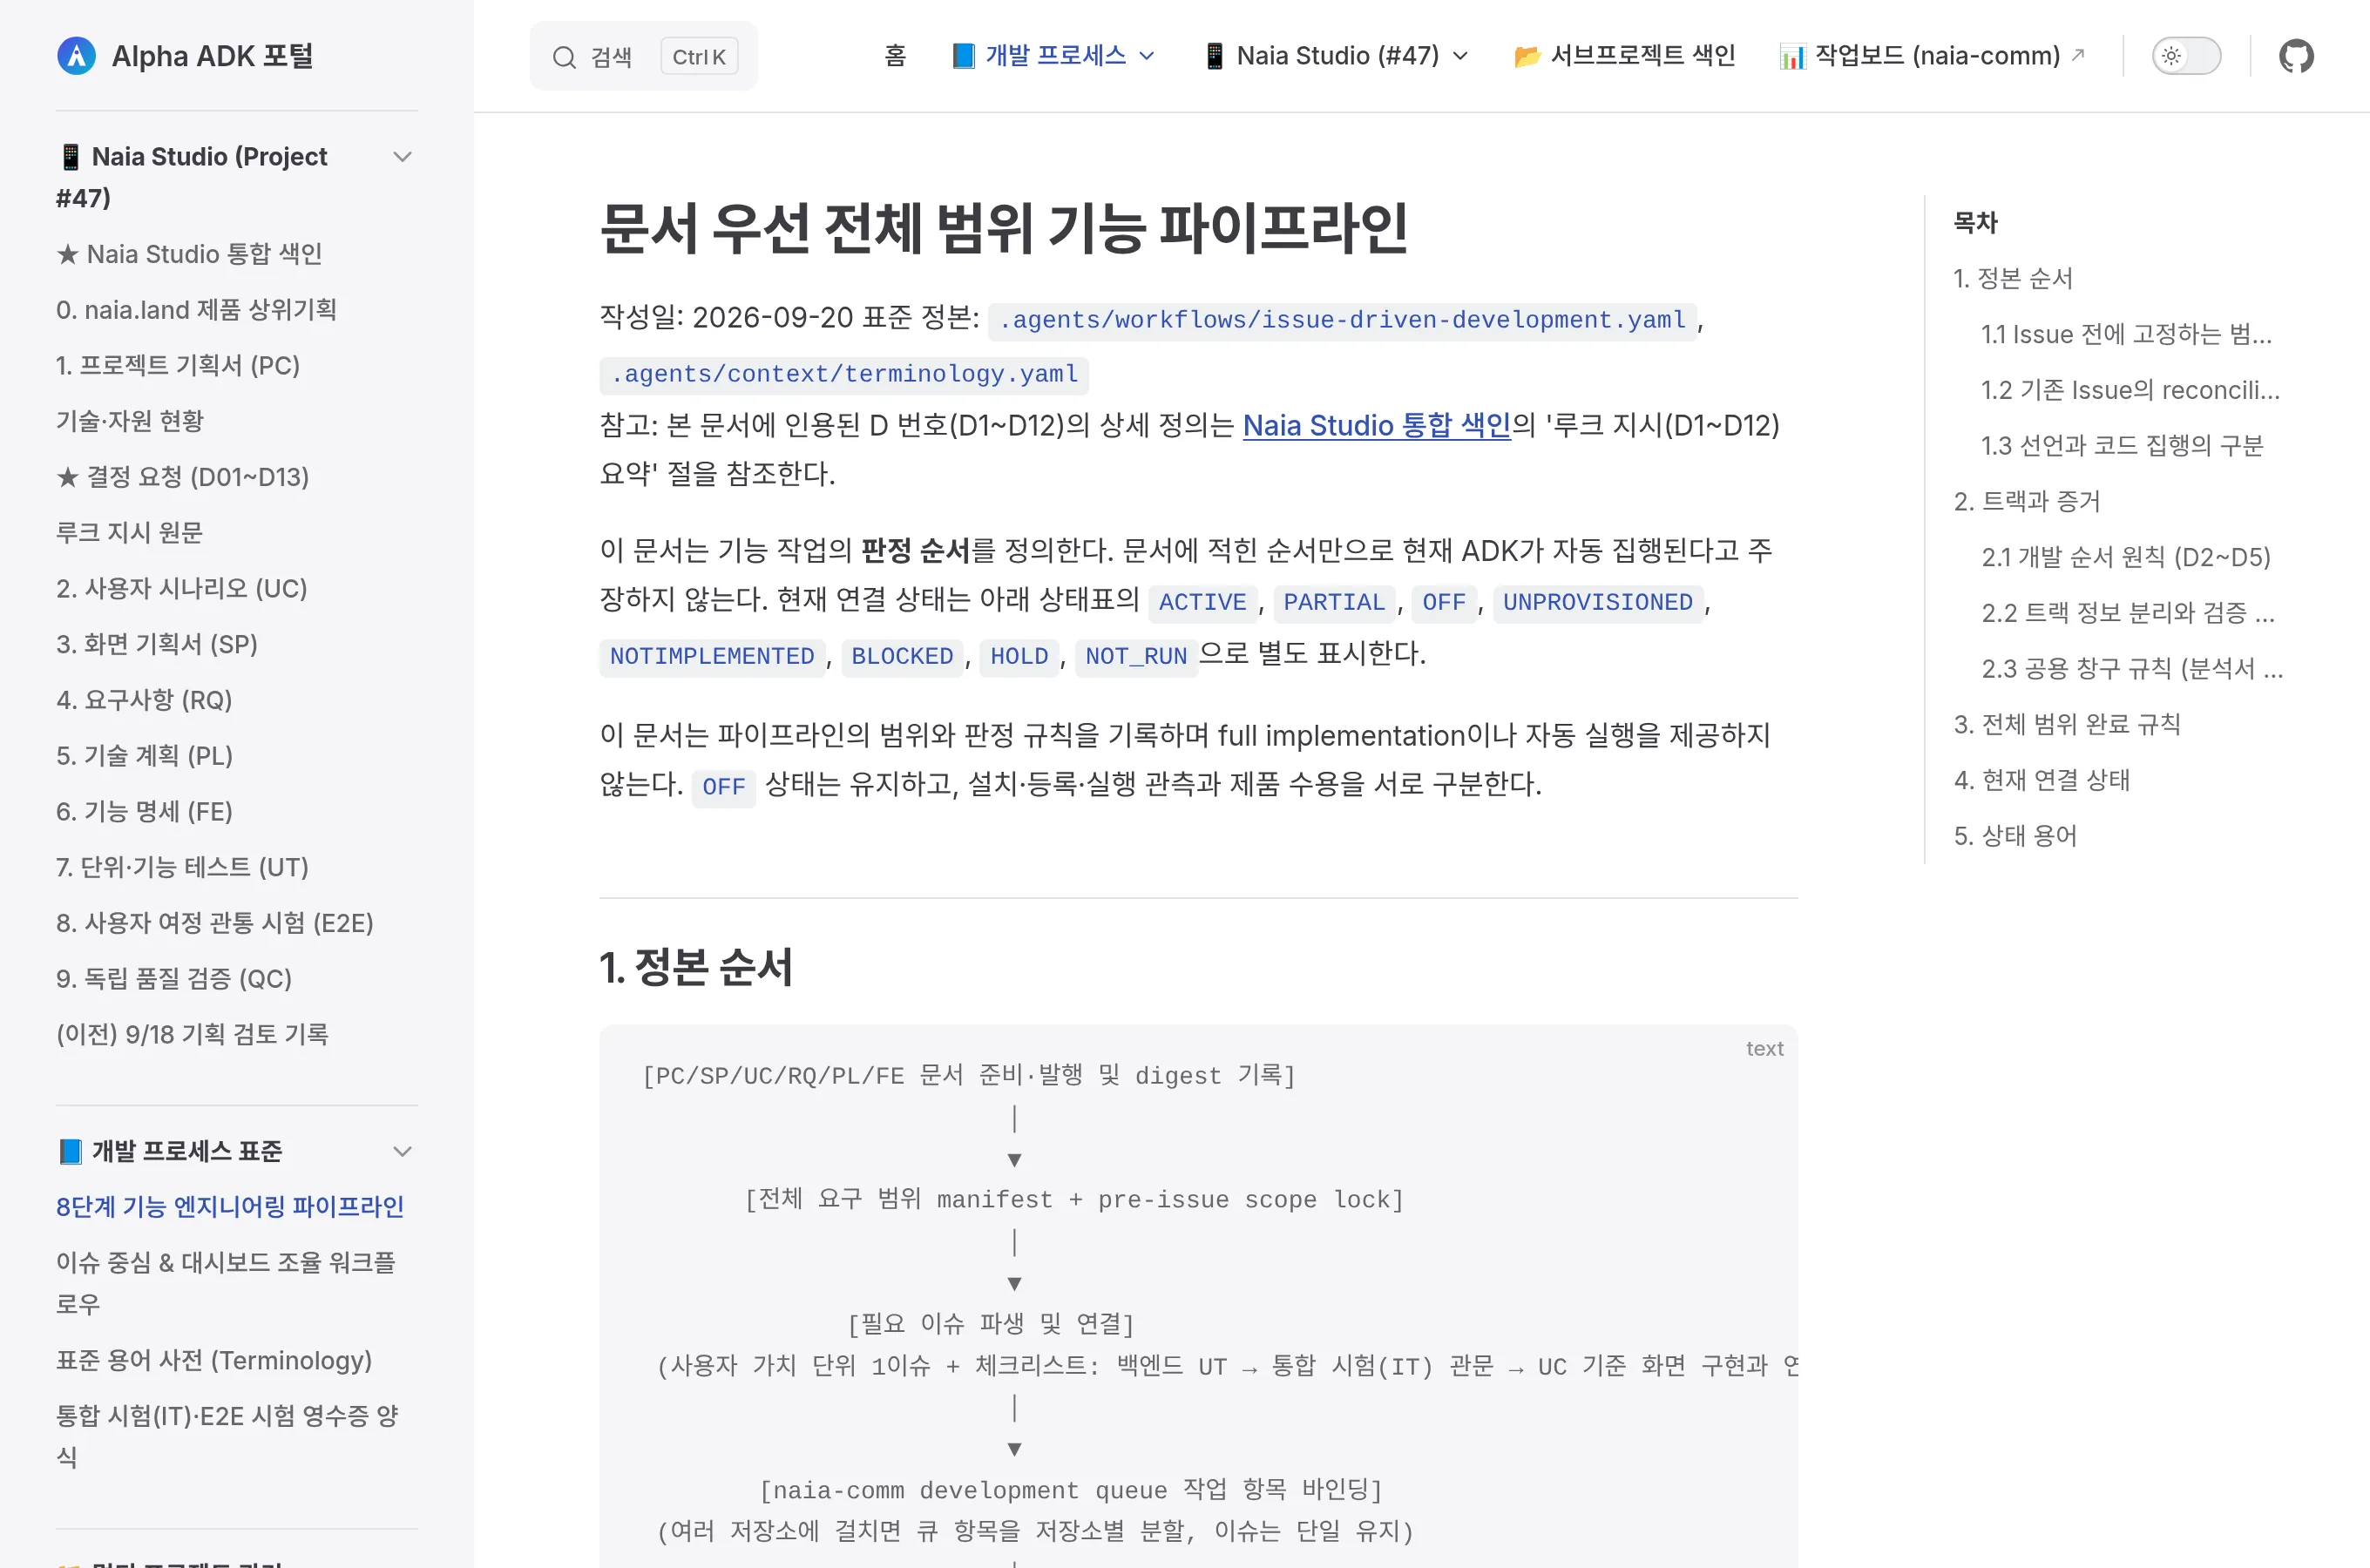 Page de procédure de développement dans le visualiseur de documents.
Les documents descendent selon l'ordre du schéma, du pourquoi nous construisons (PC) jusqu'aux unités fonctionnelles à réaliser (FE), et le plan de conception (PL) est établi après avoir d'abord mesuré concrètement les limites des modèles et des moteurs. Les tickets ne sont pas découpés par couches technologiques mais limités à un seul par valeur utilisateur, même lorsqu'ils couvrent plusieurs dépôts. Les étapes allant du backend jusqu'à la validation sont désignées sous forme de liste de contrôle au sein de ce ticket pour ne rien omettre, et l'achèvement n'est prononcé que lorsque la totalité du périmètre verrouillé par la documentation dispose de preuves tangibles.
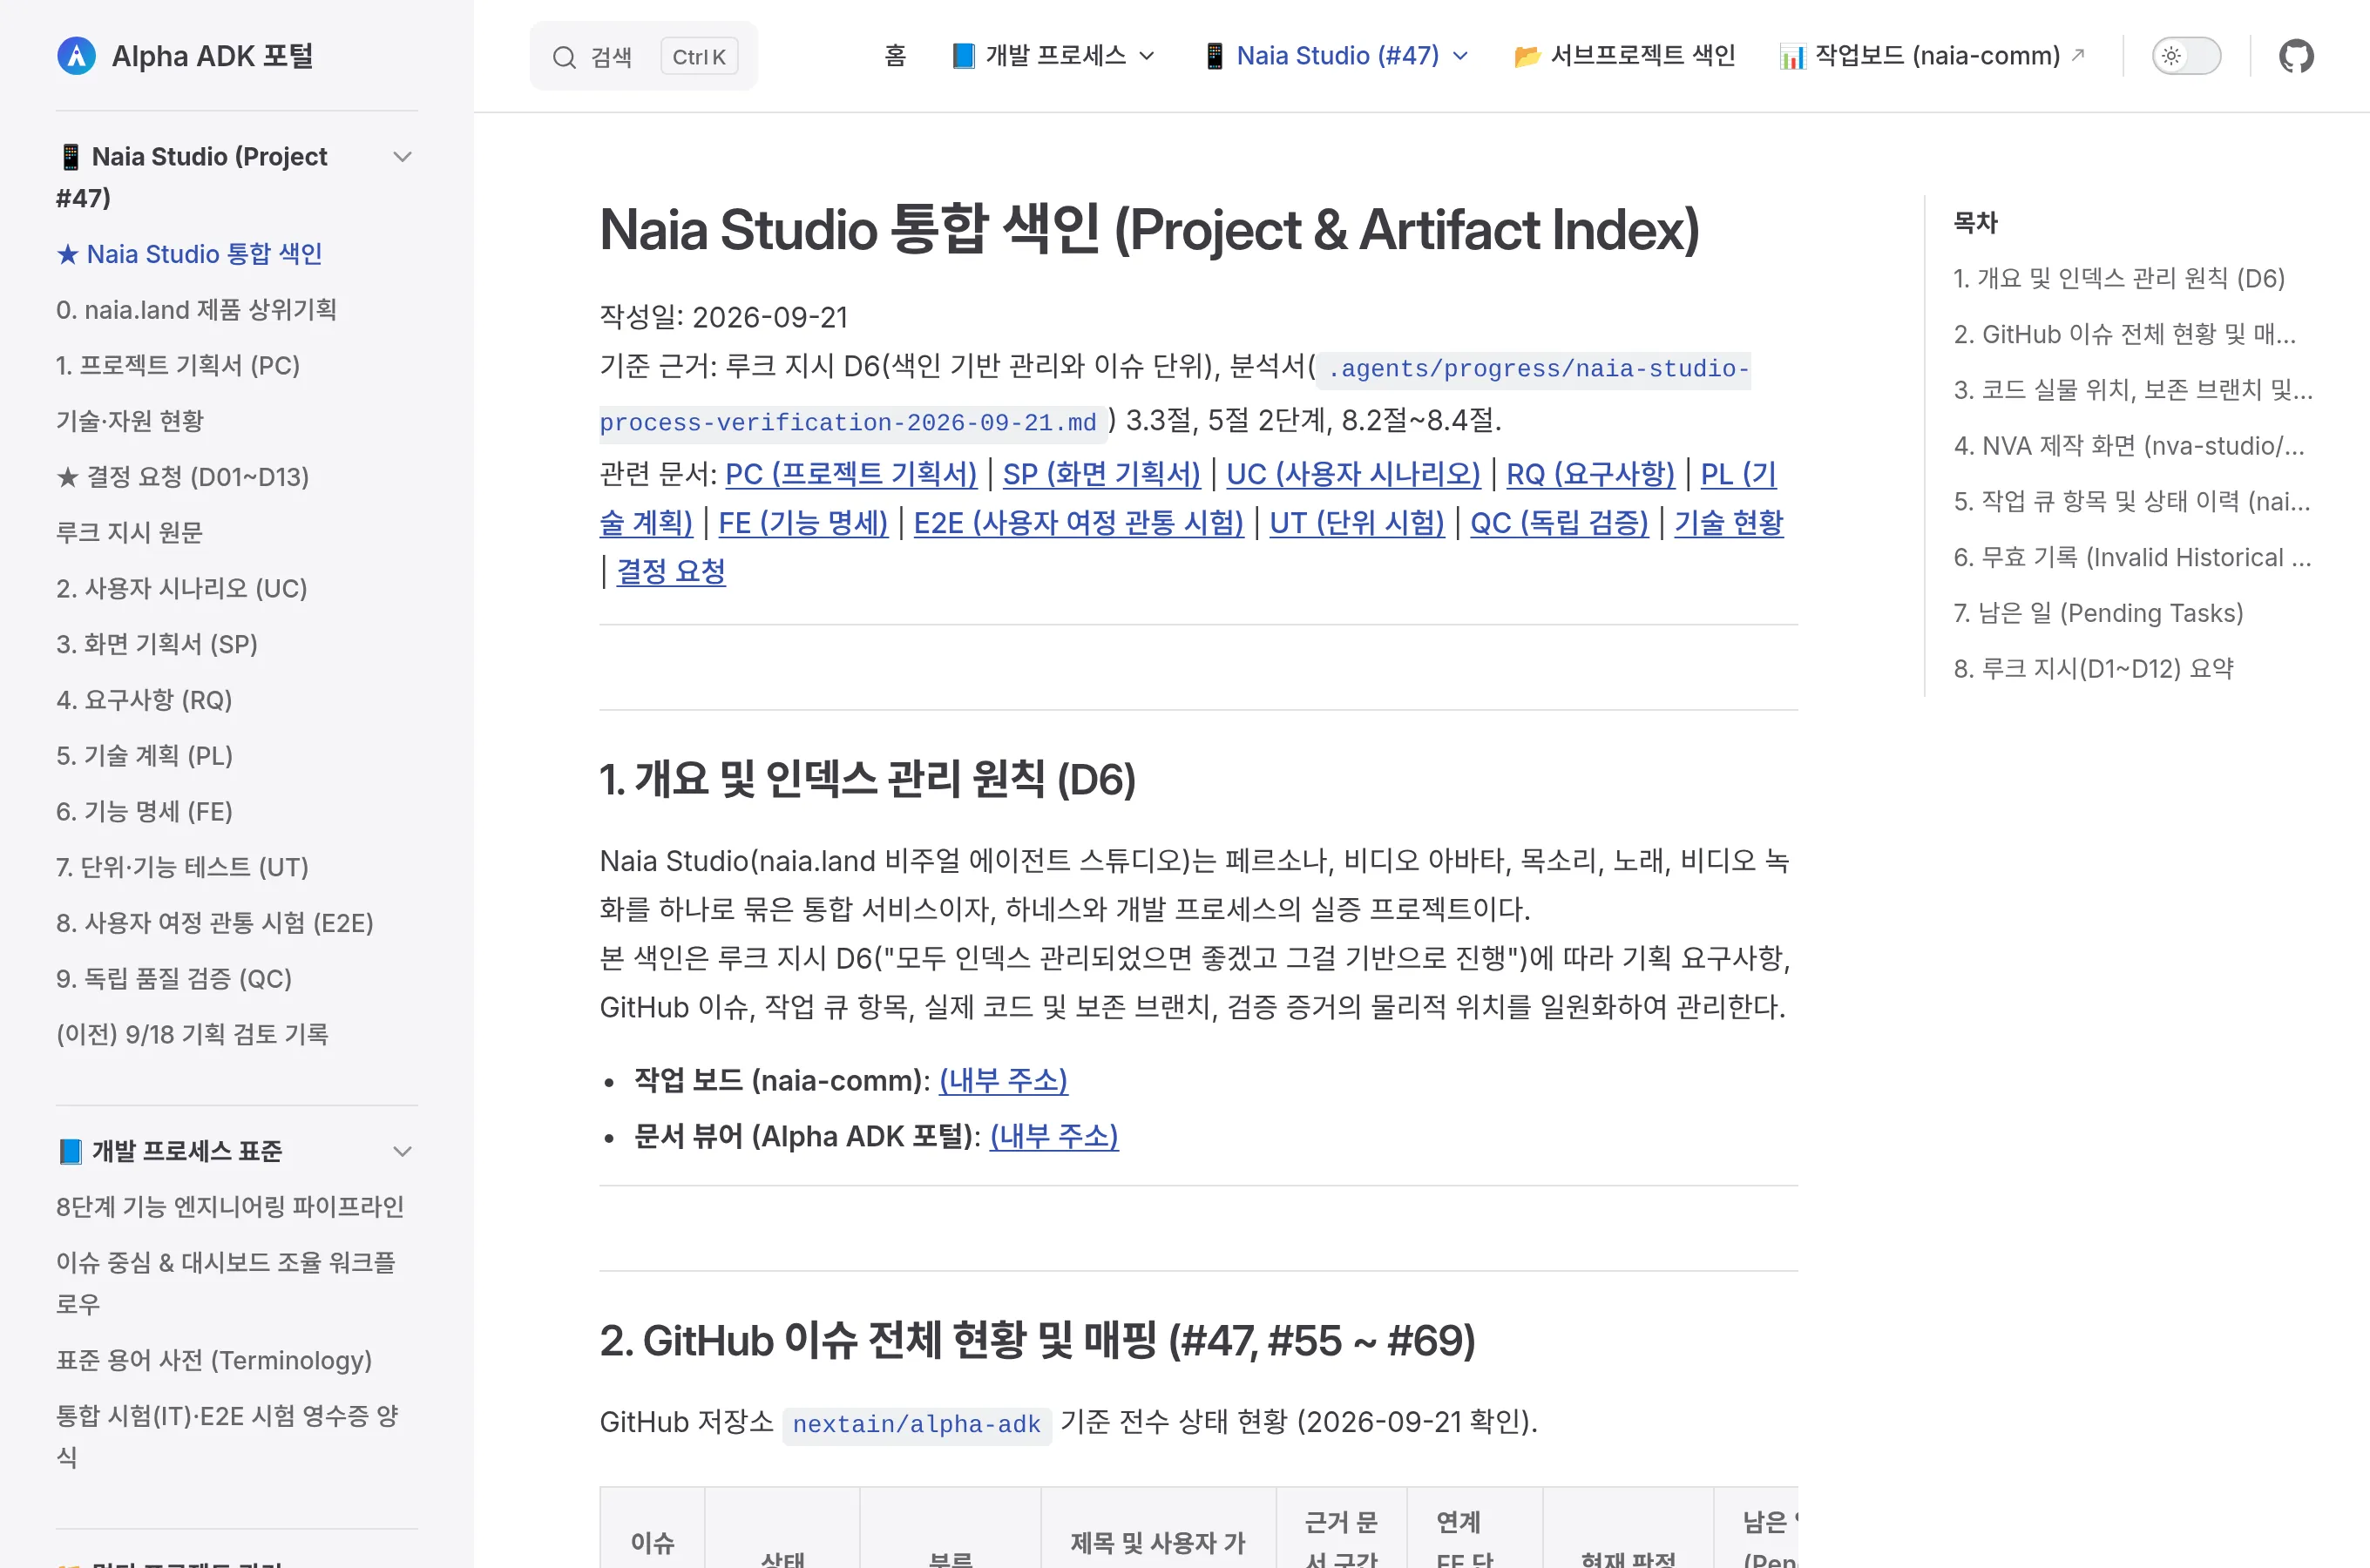 Index intégré Studio permettant de visualiser en un seul endroit les tickets, l'emplacement d'implémentation et l'état de validation de chaque section du document de planification.
3. Structure de test à 3 niveaux et règles de séquence
Les tests sont divisés en trois niveaux selon les dénominations standard de l'industrie.
- Test unitaire (UT) : Vérifie si l'unité fonctionnelle (FE) fonctionne conformément aux spécifications.
- Test d'intégration (IT) : Traverse les composants réels du backend de bout en bout sans interface. Les tests qui ne passent que par des objets fictifs (mocks) ne sont pas admis.
- Test de parcours utilisateur de bout en bout (E2E) : Traverse un parcours utilisateur complet depuis les écrans réels du navigateur jusqu'au backend réel. Seules les unités sans écran dans le SP sont clôturées par un test d'intégration sans E2E ; si des écrans existent, l'E2E est indispensable même si la modification actuelle ne concerne que le backend. La référence est le SP, et non le diff de l'implémenteur.
La clé réside dans la séquence. L'interface (UI) n'est développée qu'une fois que le backend a réussi le test d'intégration (IT). Actuellement, cette séquence n'est pas bloquée mécaniquement par le Harness, mais simplement vérifiée par des ordres de mission et des revues indépendantes au moyen de reçus, ce qui laisse une marge d'amélioration.
La validation indépendante (QC) s'exécute séparément des tests de l'implémenteur. Sans consulter UC ni FE, elle vérifie agressivement à l'aide des seuls PC et SP si les promesses du produit sont tenues face à des entrées forcées et des situations d'exception. En effet, regarder UC et FE risquerait d'inciter à ne vérifier que ce périmètre restreint. Située en fin de chaîne de développement, elle n'a pas encore fait l'objet d'une validation empirique complète.
4. File de tâches et tableau de bord basés sur Git
Afin de garantir une traçabilité fiable quant à qui a fait quoi et quand, les tâches sont gérées via une file de tâches dans un dépôt Git (naia-comm). Il n'y a pas encore de serveur partagé ; l'objectif est de créer un serveur de développement après validation pour permettre la collaboration entre plusieurs appareils et développeurs.
Chaque appareil participant clone le dépôt et effectue des tirages périodiques pour découvrir de nouvelles tâches et rapporter les journaux d'exécution. L'exécution est assurée uniquement par les runners enregistrés localement par le propriétaire de l'appareil (programmes qui prennent les tâches de la file pour faire tourner l'IA à leur place) ; la file ne contient que le nom du runner, et aucune commande à exécuter n'y figure.
Chaque étape d'une tâche est consignée dans un nouveau fichier JSON. Les preuves d'exécution et les codes de sortie sont inscrits dans les reçus de résultat, et les annulations sont ajoutées de la même manière, journalisant toutes les opérations afin de renforcer la traçabilité. Le tableau de bord n'est qu'un écran qui relit et affiche ces enregistrements à chaque demande.
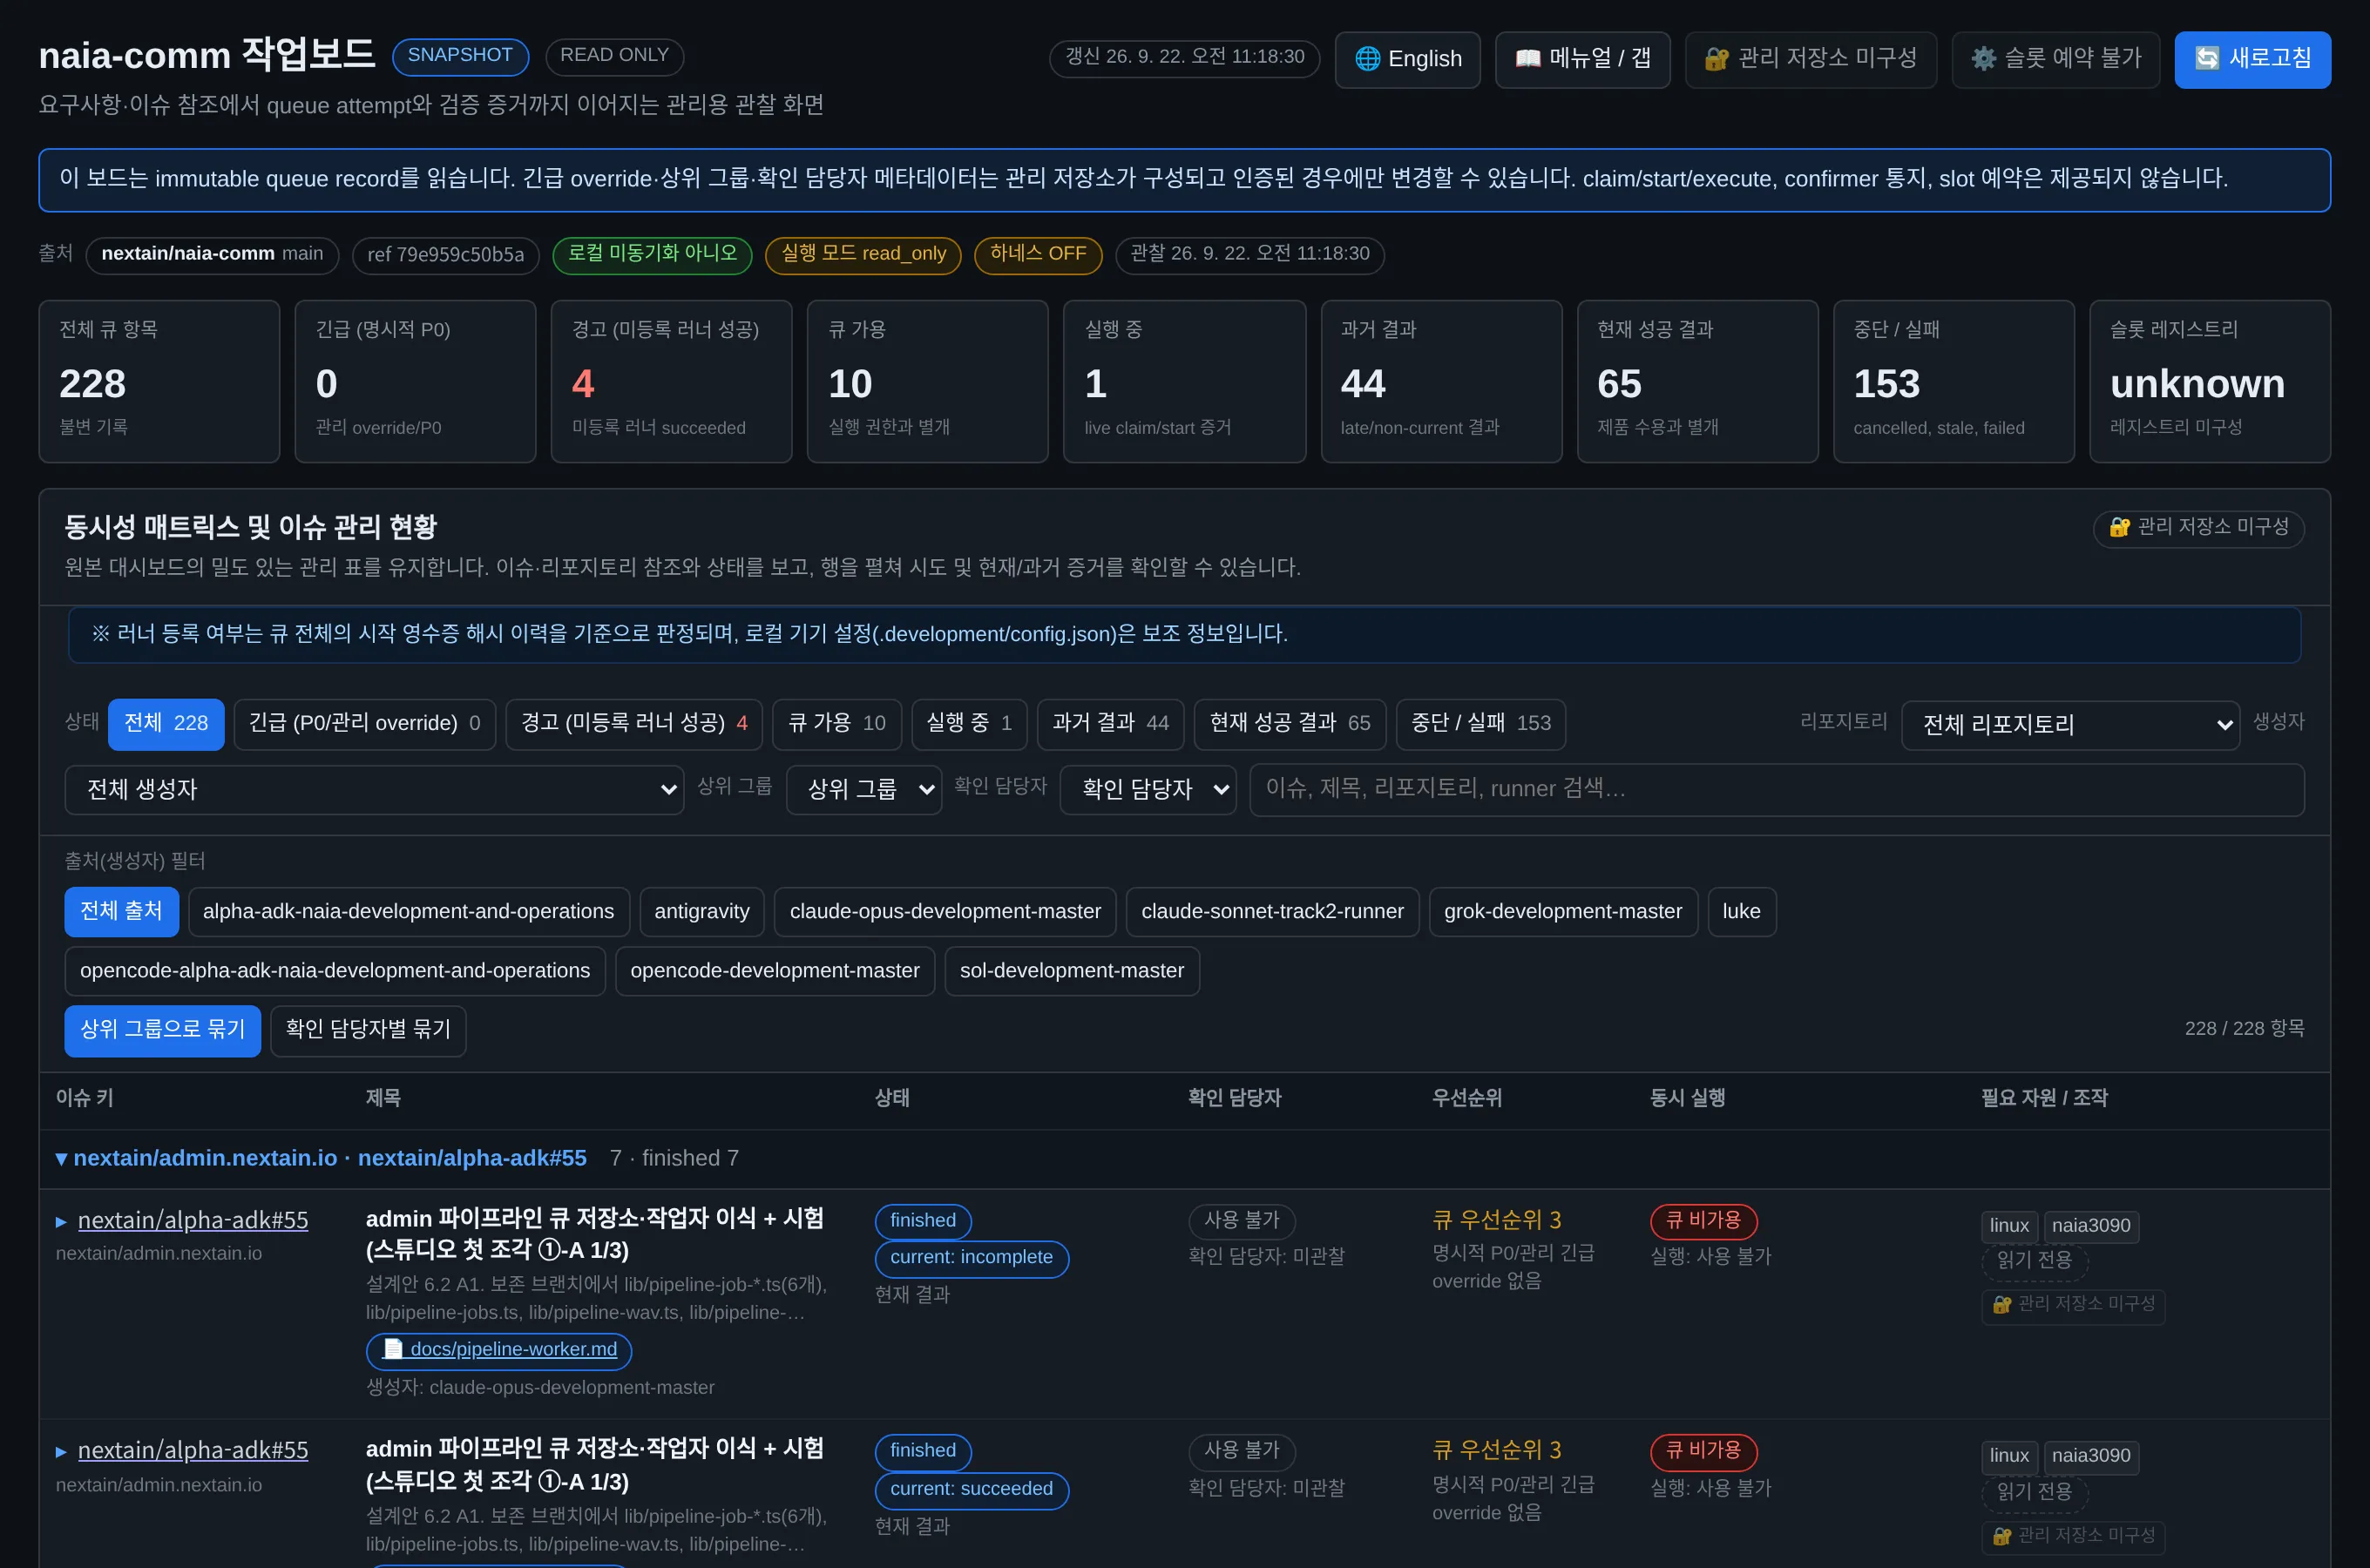 Voici l'écran du tableau de bord (les adresses internes sont masquées). Les indicateurs supérieurs agrègent les enregistrements de la file de la branche main de naia-comm : au moment de la capture, sur 228 éléments de tâche, 10 étaient disponibles, 1 en cours d'exécution et 65 résultats actuellement réussis, avec des avertissements apposés sur 4 enregistrements réussis provenant de noms de runner non enregistrés.
5. Système de règles d'exploitation et structure de collaboration multi-agents
Le système de règles d'exploitation désigne l'ensemble des règles définies par la documentation et leurs procédures de vérification. Les dispositifs de contrôle automatique sont actuellement désactivés en mode de récupération (« HARNESS OFF » sur le tableau de bord), et les verrous logiciels bloquant les règles par code n'existent pas encore ; les ordres de mission du coordinateur, les scripts de surveillance et les revues indépendantes veillent donc au respect des règles.
Utiliser uniquement des modèles haut de gamme augmente considérablement les coûts, tandis que n'utiliser que des modèles légers conduit à des échecs de conception et de validation, compromettant le projet. C'est pourquoi nous répartissons les modèles selon la nature des tâches et les faisons se valider mutuellement.
| Rôle | Modèle assigné | Mode d'exécution et mission |
|---|---|---|
| Analyse et plan de conception | Claude Fable | Analyse du contexte global du système, établissement du plan d'analyse technique et d'architecture (PL), conception du plan de validation du processus |
| Coordination des tâches (Master) | Claude Opus | Répartition globale des tâches et contrôle du flux ; surveille les agents sans rédiger directement de code produit |
| Implémentation du code et tests | Gemini 3.8 Flash | Exécute des outils en ligne de commande (CLI, Command-Line Interface) sans dialogue (l'exécution sans surveillance étant conçue pour passer par le runner). Les tests sont confiés à une session Flash distincte de celle de l'implémentation |
| Revue contradictoire | Claude Opus | Engagé dans une session neuve à chaque tour ; mène une enquête indépendante sur les sources d'origine et confronte les soumissions pour extraire les défauts modifiant les conclusions |
| Implémentation du code du runner | Claude Sonnet | Implémenté par un autre modèle pour éviter que l'exécutant (agy) n'écrive du code élargissant ses propres privilèges, comme faire appeler les agents agy par le runner avec une approbation automatique générale |
※ La répartition des modèles est en cours d'expérimentation et susceptible d'évoluer.
Grâce à l'efficacité des coûts et à la séparation des privilèges, les implémentations volumineuses et les itérations de test sont confiées à Gemini 3.8 Flash pour préserver les quotas des modèles haut de gamme, tandis que les modèles adaptés à chaque rôle font l'objet d'une recherche et d'ajustements constants. Les exécutants ne pouvant élargir leurs propres autorisations, le risque qu'un agent s'accorde des privilèges et cause des problèmes s'en trouve réduit. En revanche, des bogues dans cette fonctionnalité provoquant fréquemment des blocages où les tâches restent isolées et bloquées, nous poursuivons les tests et les améliorations.
Par exemple, les vérifications d'emplacement telles que « correspondance avec le checkout du dépôt déclaré » ne s'activent que lors du passage par le runner, et ne s'appliquent pas aux exécutions lancées directement par ordre de mission.
6. Revue contradictoire fondée sur une enquête indépendante
Avant d'ouvrir une soumission, le réviseur enquête d'abord lui-même directement sur les instructions d'origine, le dépôt, les commits et les enregistrements de la file de tâches afin de rédiger ses propres conclusions, puis les confronte à la soumission. Consulter uniquement la soumission fait en effet risquer de passer à côté de prémisses erronées ou d'un dépôt inapproprié. Un réviseur neuf intervient à chaque fois, et la validation est accordée lorsqu'il n'y a aucune remarque remettant en cause les conclusions lors de deux tours consécutifs. Si une boucle de remarques futiles se répète, le processus s'arrête et transmet le dossier à un humain pour décision.
7. Résultats observés et limites
Résultats observés
Un dispositif s'est mis en place dans lequel un modèle économique (Gemini 3.8 Flash) assure l'implémentation via des sessions en ligne de commande non conversationnelles, le coordinateur surveille les périmètres grâce aux ordres de mission et aux scripts de surveillance, et un modèle supérieur confronte les résultats après une enquête indépendante menée à chaque tour dans une session neuve. Les scripts de surveillance affichent a posteriori les commandes exécutées par l'agent, et le réviseur est en mesure d'intercepter les déclarations factuelles erronées formulées par ce dernier.
Limites observées et vulnérabilités
Les modèles bon marché et moins performants ont fréquemment tendance à avancer sans respecter les consignes. Ils déclarent des tâches terminées avec des identifiants de file inexistants, insèrent dans les documents de procédure des clauses d'exemption non demandées, ou altèrent subtilement les conditions d'origine lors de la synthèse. La session de test se contente de vérifier si le script passe, sans pouvoir discerner si ce test s'exécute réellement sur le véritable backend.
Bien que la revue indépendante filtre ces anomalies, le coût de vérification est élevé. En effet, l'effort des modèles de révision supérieurs est largement accaparé par des vérifications matérielles de faits. C'est également la raison pour laquelle nous continuons de tester la configuration de modèle optimale pour chaque rôle.
8. Efficacité de la vérification grâce à Jev et perspectives d'avenir
Afin de réduire la charge de révision, nous avons tenté de diviser la vérification en trois niveaux. Au deuxième niveau, nous menons actuellement une validation technique pour étudier l'introduction de Jev, qui se distingue par son faible coût et sa rapidité.
- Premier niveau, vérification mécanique (scripts) : Les contrôles qui ne nécessitent qu'une simple comparaison : succès ou échec des reçus de test (0 échec, code de sortie 0), réponse d'URL, existence de fichiers.
- Deuxième niveau, détermination de type (Jev) : Lorsque les reçus de test d'intégration (IT) et d'E2E affichent « succès », discerner si le test a véritablement traversé le backend réel ou s'il n'a fait que passer par des simulations fictives. Les tests unitaires (UT) pouvant initialement utiliser des mocks, ils ne sont pas concernés.
- Troisième niveau, appréciation de la direction (modèles supérieurs et humains) : Vérifier l'adéquation du périmètre et de l'intention.
Jev est un modèle de décision développé par TypeSafe AI, un modèle économique qui répond rapidement en se limitant à des choix et des probabilités prédéterminés. Le développement logiciel comportant de nombreux problèmes de choix, une mesure continue permet de trouver le seuil approprié (Threshold) pour concilier rentabilité et rapidité. Il s'agit d'une approche d'optimisation couramment employée dans le développement logiciel IA traditionnel avant l'avènement des LLM, et les résultats de validation sont les suivants.
Résultats de la validation
En n'adoptant la décision de Jev que lorsque le score de confiance est supérieur ou égal à 0,85 et qu'il donne la même réponse même sous une formulation différente — le reste étant délégué à de grands modèles de langage (LLM) —, nous avons mesuré et estimé sur 871 fichiers de test (257 en évaluation finale) que le temps pouvait être réduit d'environ 66 % et les coûts d'environ 60 à 70 % (le temps étant mesuré par rapport à Gemini 3.8 Flash, et les coûts estimés d'après le tarif unitaire de modèles tels qu'Opus et Luna).
| Méthode de décision | Fichiers traités par Jev | Réponses erronées | Temps passé (vs utilisation exclusive de LLM) |
|---|---|---|---|
| Utilisation exclusive de LLM | 0% | Référence | 100% |
| Règle actuelle (Confiance >= 0,85 + Réponse identique sous formulation alternative) | Env. 72% | 0 cas sur les fichiers de consensus entre deux IA | 34% (48% en exécutant par 4 en parallèle) |
| En abaissant le seuil à 0,59 | Env. 89% | Augmentation de 1,8%p | 17% |
Le coût de 971 appels à Jev s'est élevé à 0,22 dollar, et une décision prenait environ 0,7 seconde avec Jev contre environ 12 secondes avec un LLM.
Nous continuons à chercher les valeurs optimales en élargissant les expériences. Bien que le potentiel soit confirmé, il n'a pas encore été raccordé au processus de développement réel. Les réponses de référence n'ayant retenu que les fichiers pour lesquels les deux IA fournissaient la même réponse, les résultats ont pu être biaisés en faveur de fichiers plus simples.
Perspectives d'avenir
Grâce à cette procédure, la première fonctionnalité de Studio (saisir un scénario pour générer, écouter et télécharger une voix) a été finalisée, du backend jusqu'au test de parcours utilisateur de bout en bout. Les défis restants consistent à automatiser davantage la validation et à faire appliquer par des outils les règles actuellement maintenues par des humains et des ordres de mission. Nous prévoyons également une expérience séparée pour tester si Jev peut servir non seulement au marquage de validation, mais aussi au contrôle du flux pour choisir la tâche suivante lorsqu'une tâche se termine. En effet, ce jugement d'enchaînement nécessite actuellement d'appeler un modèle supérieur pour chaque tâche, ce qui représente un coût et une latence considérables.
J'espère que ces éléments partagés vous seront utiles. Nous vous remercions chaleureusement pour l'intérêt que vous portez aux produits Naia. Nous devons sortir rapidement des produits pour faire la démonstration de nos résultats et franchir un nouveau cap, mais nous avons l'impression de continuer à consacrer énormément de temps aux méthodes rigoureuses de contrôle et de développement de l'IA.
