Quy trình phát triển đa AI dựa trên tài liệu trong Naia ADK: Thử nghiệm nâng cao hiệu quả với Jev
 Xin chào. Tôi là Luke, người sáng lập Naia.
Naia có vẻ giống như một sản phẩm tác tử nhân vật dành cho người dùng thông thường, nhưng phần lớn công việc hàng ngày của tôi là phát triển phần mềm. Do đó, chúng tôi xây dựng hạ tầng phát triển phục vụ mục đích này và tiến hành phát triển phần mềm cho các khách hàng doanh nghiệp bằng hạ tầng phát triển của Naia. Trước đây, tôi từng xuất bản một cuốn sách có tựa đề "Harness Engineering: Kỹ nghệ phần mềm AI bắt đầu từ Re:Zero" (bản tiếng Hàn, bản tiếng Anh). Kể từ đó, chúng tôi vẫn không ngừng nỗ lực để thiết lập tốt hơn nữa quy trình phát triển dựa trên tác tử AI.
Hôm nay, tôi xin công khai quy trình phát triển phần mềm và các sản phẩm bàn giao được xây dựng phục vụ phát triển Naia, đồng thời chia sẻ cách chúng tôi đang cố gắng đưa Jev, mô hình quyết định đang rất được quan tâm gần đây, vào quy trình phát triển này.
Có 3 mục tiêu cốt lõi mà tôi muốn theo đuổi trong quy trình phát triển này: tính trực quan (Visibility), tính song song (Parallelization), và tối ưu hóa chi phí (Cost Optimization).
- Tính trực quan : Biết được việc phát triển có đang diễn ra đúng hướng hay không, và nếu xảy ra hiện tượng trôi dạt mô hình (model drift), có thể xác định chính xác vấn đề phát sinh ở giai đoạn nào.
- Tính song song : Phân chia công việc song song cho nhiều tác tử để tăng tốc độ phát triển.
- Tối ưu hóa chi phí : Sử dụng các mô hình tối ưu về chi phí. Jev cũng là một giải pháp thay thế tuyệt vời ở khía cạnh này.
Khung cơ bản của hệ thống quy tắc làm việc (Harness) đã được công khai dưới dạng mã nguồn mở bên dưới:
- Khung cơ bản cho không gian làm việc cá nhân và hệ thống quy tắc làm việc (Harness): nextain/naia-adk
- Khung cơ bản dành cho cộng tác nhóm và dự án: nextain/naia-pj-adk
- Hướng dẫn tham gia cộng đồng: nextain/naia-comm-public
- Jev là mô hình quyết định do TypeSafe AI công bố.
Hàng đợi tác vụ, bảng công việc, runner và tài liệu kế hoạch được mô tả trong bài viết này vẫn đang trong quá trình phát triển nội bộ và hiện chưa công khai. Hiện tại, quy trình này cũng đang ở giai đoạn xác thực, được thử nghiệm trên tính năng mới sắp ra mắt trên nền tảng web của Naia: phát triển Naia Visual Agent Studio, một avatar video có khả năng hát và đồng bộ khẩu hình môi. Lý do chưa công khai là vì chúng chưa đủ hoàn thiện để cùng sử dụng trong các dự án nhóm; chúng tôi sẽ công khai thêm ngay khi sắp xếp xong.
Các từ viết tắt sử dụng trong bài viết này và tài liệu phát triển của chúng tôi
Trước hết, tài liệu phát triển, issue và hàng đợi tác vụ của chúng tôi sử dụng các từ viết tắt dưới đây và có một từ điển thuật ngữ chuẩn cho dự án. Điều này được áp dụng vì tôi không thích gõ các câu lệnh dài dòng cho AI và để tránh nguy cơ nhầm lẫn thuật ngữ.
| Viết tắt | Tên đầy đủ | Thuật ngữ | Ý nghĩa trong một dòng |
|---|---|---|---|
| PC | Product / Project Concept | Lập kế hoạch cấp cao | Vì sao chúng ta xây dựng: bản chất sản phẩm, lý do tồn tại, giá trị người dùng, kiến trúc thông tin tổng thể |
| SP | Screen Plan | Kế hoạch màn hình | Bản vẽ cấu trúc các màn hình người dùng sẽ thấy (bố cục, sắp đặt, điều hướng) |
| UC | User Scenario | Hành trình người dùng (Kịch bản người dùng) | Toàn bộ hành trình người dùng bước vào theo một ngữ cảnh, đạt được mục tiêu và rời đi |
| RQ | Requirements | Yêu cầu | Các điều kiện và tiêu chí nghiệm thu có thể đo lường mà hệ thống phải đáp ứng để thỏa mãn UC và SP |
| PL | Plan / Architecture | Phân tích kỹ thuật & Kế hoạch thiết kế | Xác minh thực tế kỹ thuật qua đo lường thực tế và lập kiến trúc cùng kế hoạch triển khai từng bước |
| FE | FEature | Đặc tả tính năng | Các đơn vị chức năng cụ thể được xây dựng để hiện thực hóa UC và RQ. Không phải Frontend |
| UT | Unit Test | Kiểm thử đơn vị | Xác minh đơn vị chức năng có hoạt động theo đặc tả hay không |
| IT | Integration Test | Kiểm thử tích hợp | Kiểm thử xuyên suốt các thành phần backend thực tế đến cùng mà không cần giao diện. Không phải công nghệ thông tin (IT) |
| E2E | End-to-End Test | Kiểm thử hành trình người dùng đầu cuối | Kiểm thử xuyên suốt một hành trình người dùng từ màn hình thực tế đến backend thực tế |
| QC | Quality Control / Validation | Nghiệm thu độc lập | Kiểm tra tính hợp lệ của cam kết sản phẩm một cách nghiêm ngặt chỉ dựa trên PC và SP mà không xem kịch bản của lập trình viên hay triển khai nội bộ |
1. Bối cảnh áp dụng và nhận thức vấn đề
Nếu giao phó việc phát triển cho các tác tử AI một cách lỏng lẻo, chúng thường bắt đầu tạo giao diện người dùng (UI, User Interface) khi chưa có backend, hoặc báo cáo các bài kiểm thử chạy với đối tượng giả lập (mock) là đã vượt qua. Do đó, chúng tôi tiến hành lập kế hoạch từ trên xuống (Top-down) và phát triển từ dưới lên (Bottom-up). Kế hoạch bắt nguồn từ trải nghiệm người dùng tổng thể, còn quá trình phát triển được xây dựng từ đơn vị hoạt động nhỏ nhất, và chỉ gắn màn hình giao diện sau khi backend đã thực sự được thông suốt. Bắt đầu từ màn hình giao diện rất dễ dẫn đến việc phải sửa chữa lớn khi tích hợp.
2. Quy trình làm việc và quy trình phát triển dựa trên tài liệu
Việc viết tài liệu trước nhằm mục đích chốt trước phạm vi xây dựng và tiêu chí nghiệm thu. Bằng cách tài liệu hóa các yêu cầu thay vì chỉ đưa ra những câu lệnh prompt đơn thuần, chúng ta có thể truy vết nguyên nhân gốc rễ khi phát sinh sự cố.
Chúng tôi trải toàn bộ tài liệu của quy trình phát triển thành danh sách, và chỉ sau khi có sự xác nhận của con người mới tạo issue và các mục hàng đợi tác vụ. Trước khi tạo issue mới, AI sẽ xem xét issue đó liên quan đến những tài liệu nào và rà soát lại các issue đã mở trước đó. Chỉ khi issue, hàng đợi và biên nhận kiểm thử đều có mặt đầy đủ thì mới có thể kết luận hoàn thành nhiệm vụ.
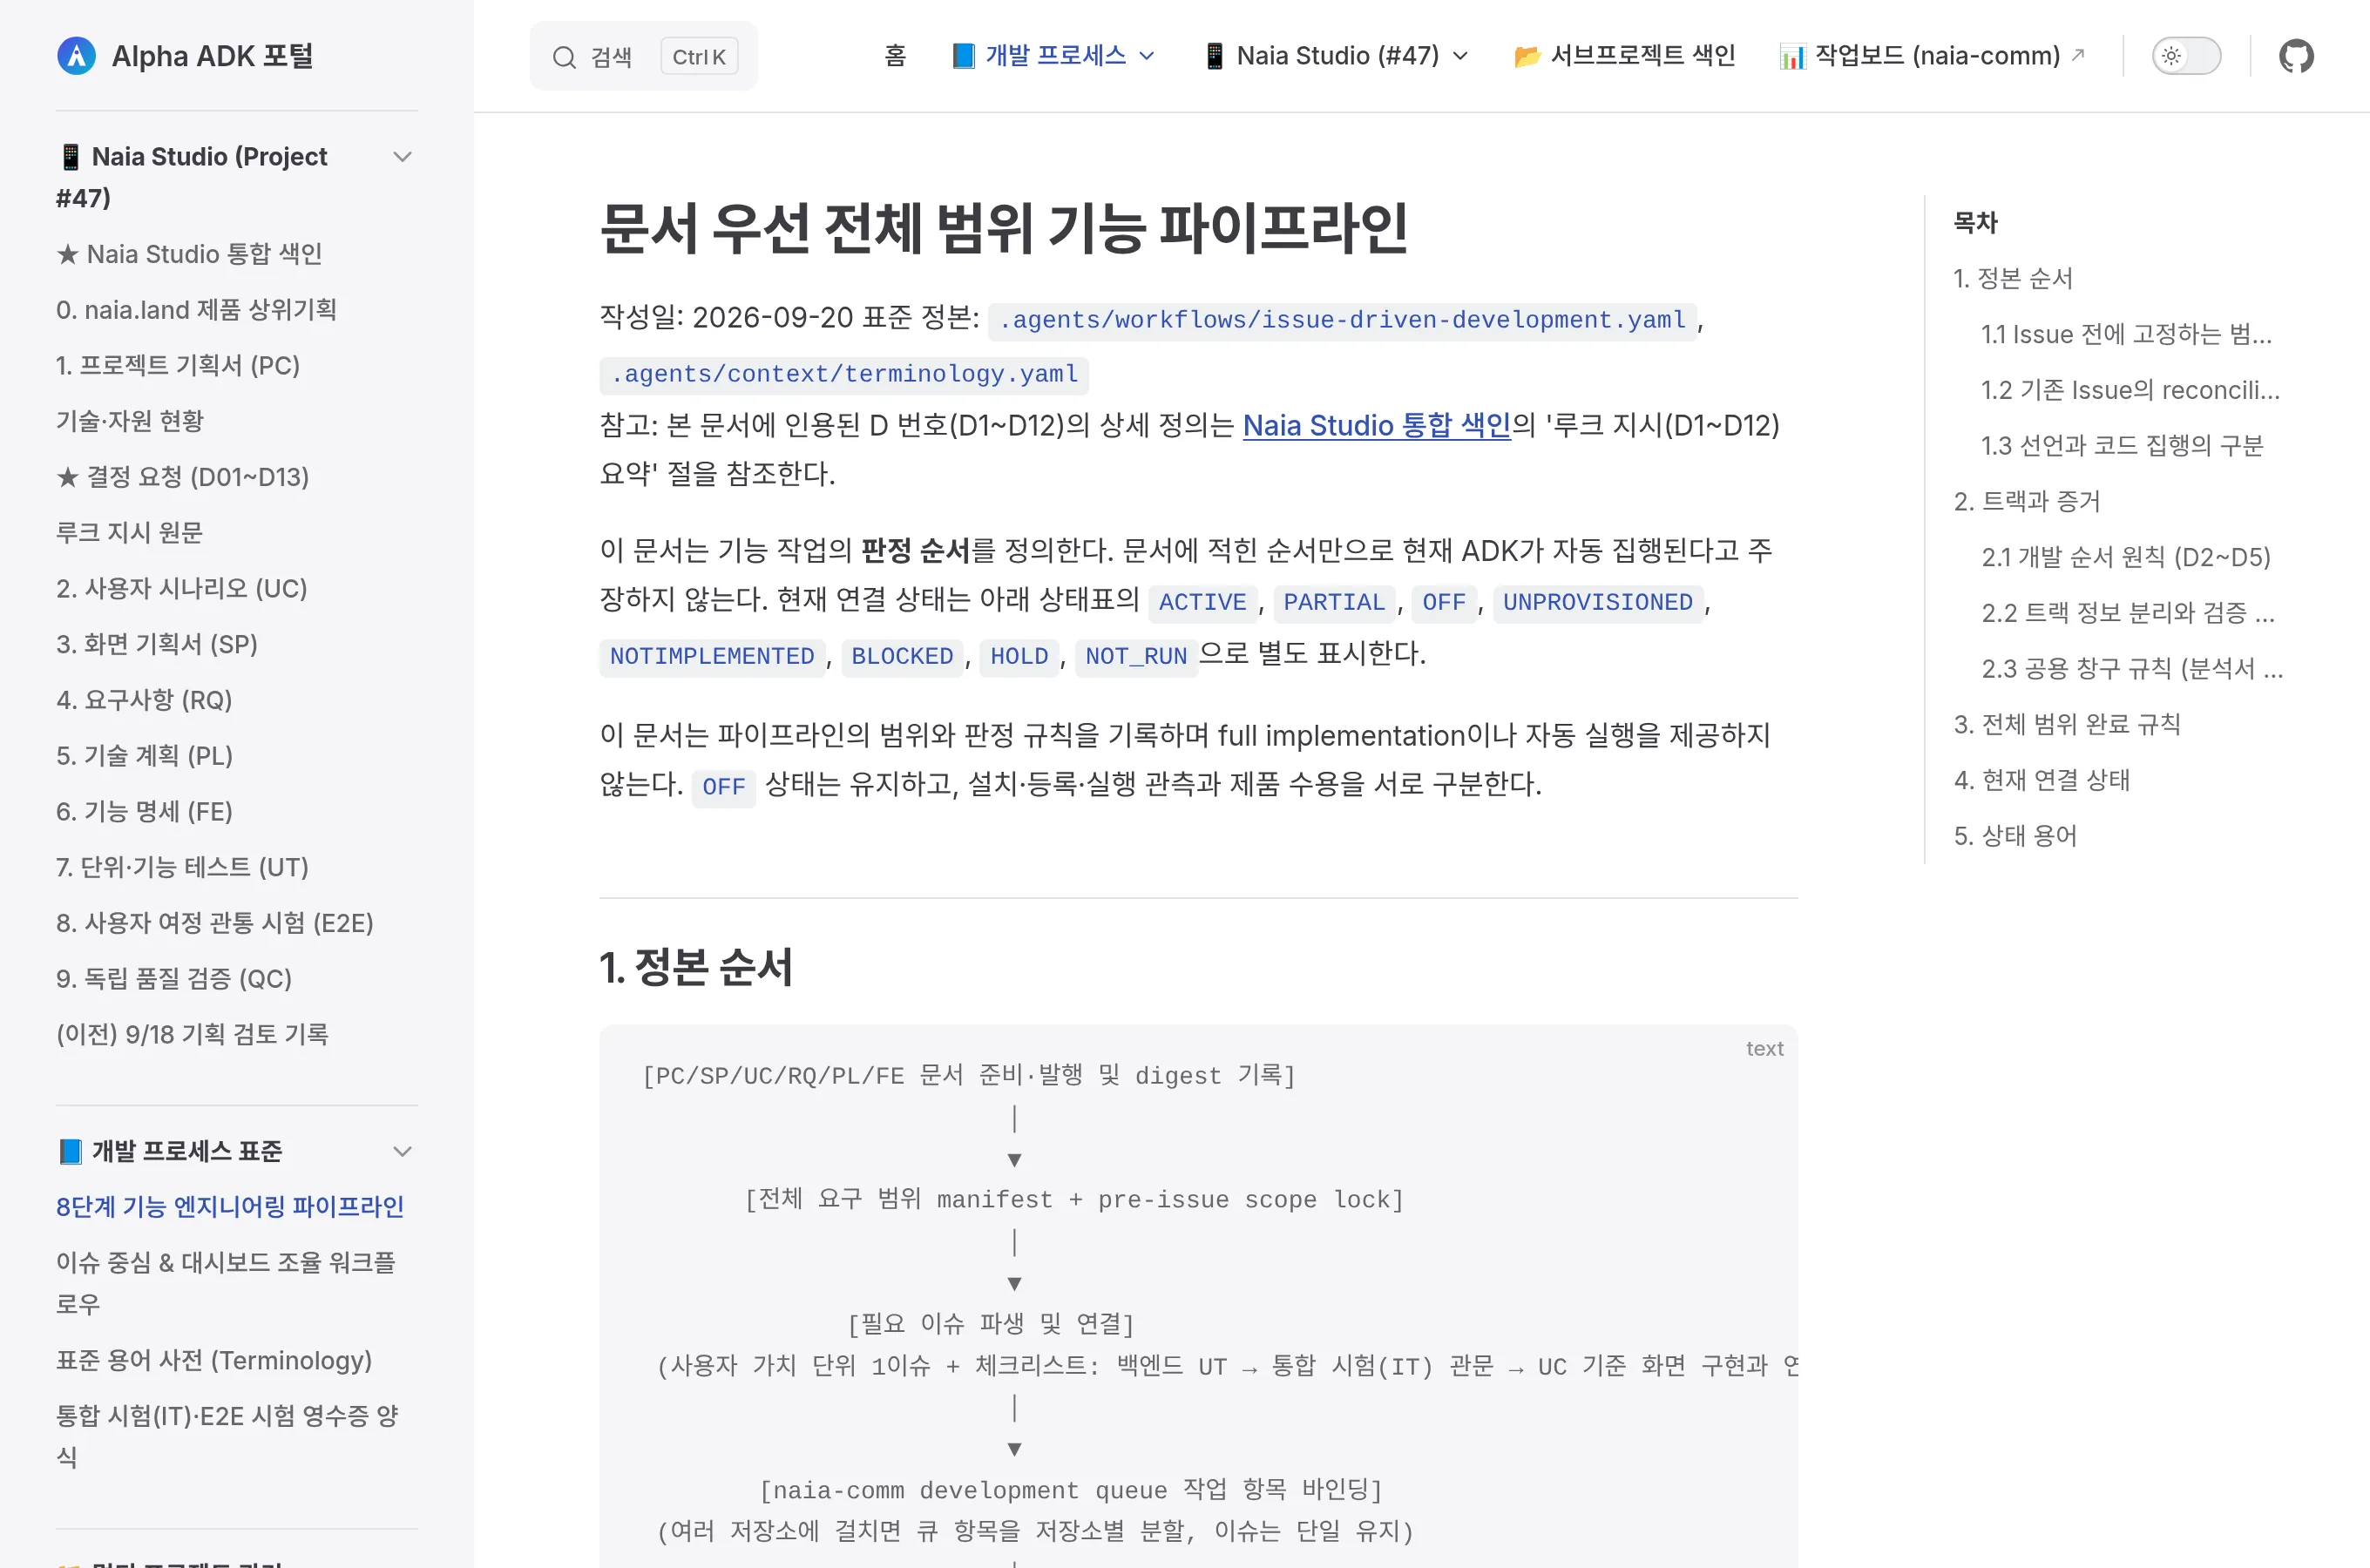 Trang quy trình phát triển trong trình xem tài liệu.
Các tài liệu đi xuống theo thứ tự sơ đồ từ lý do xây dựng (PC) đến các đơn vị tính năng cần tạo (FE), và kế hoạch thiết kế (PL) chỉ được lập sau khi đã đo lường thực tế giới hạn của mô hình và công cụ trước. Issue không bị chia cắt theo các tầng công nghệ mà được giữ duy nhất một issue cho mỗi giá trị người dùng, ngay cả khi trải rộng trên nhiều kho mã. Quy trình từ backend đến nghiệm thu được chỉ định thành danh sách kiểm tra (checklist) bên trong issue đó để không bỏ sót, và việc hoàn thành chỉ được công nhận khi toàn bộ phạm vi bị khóa bởi tài liệu đã có đầy đủ bằng chứng.
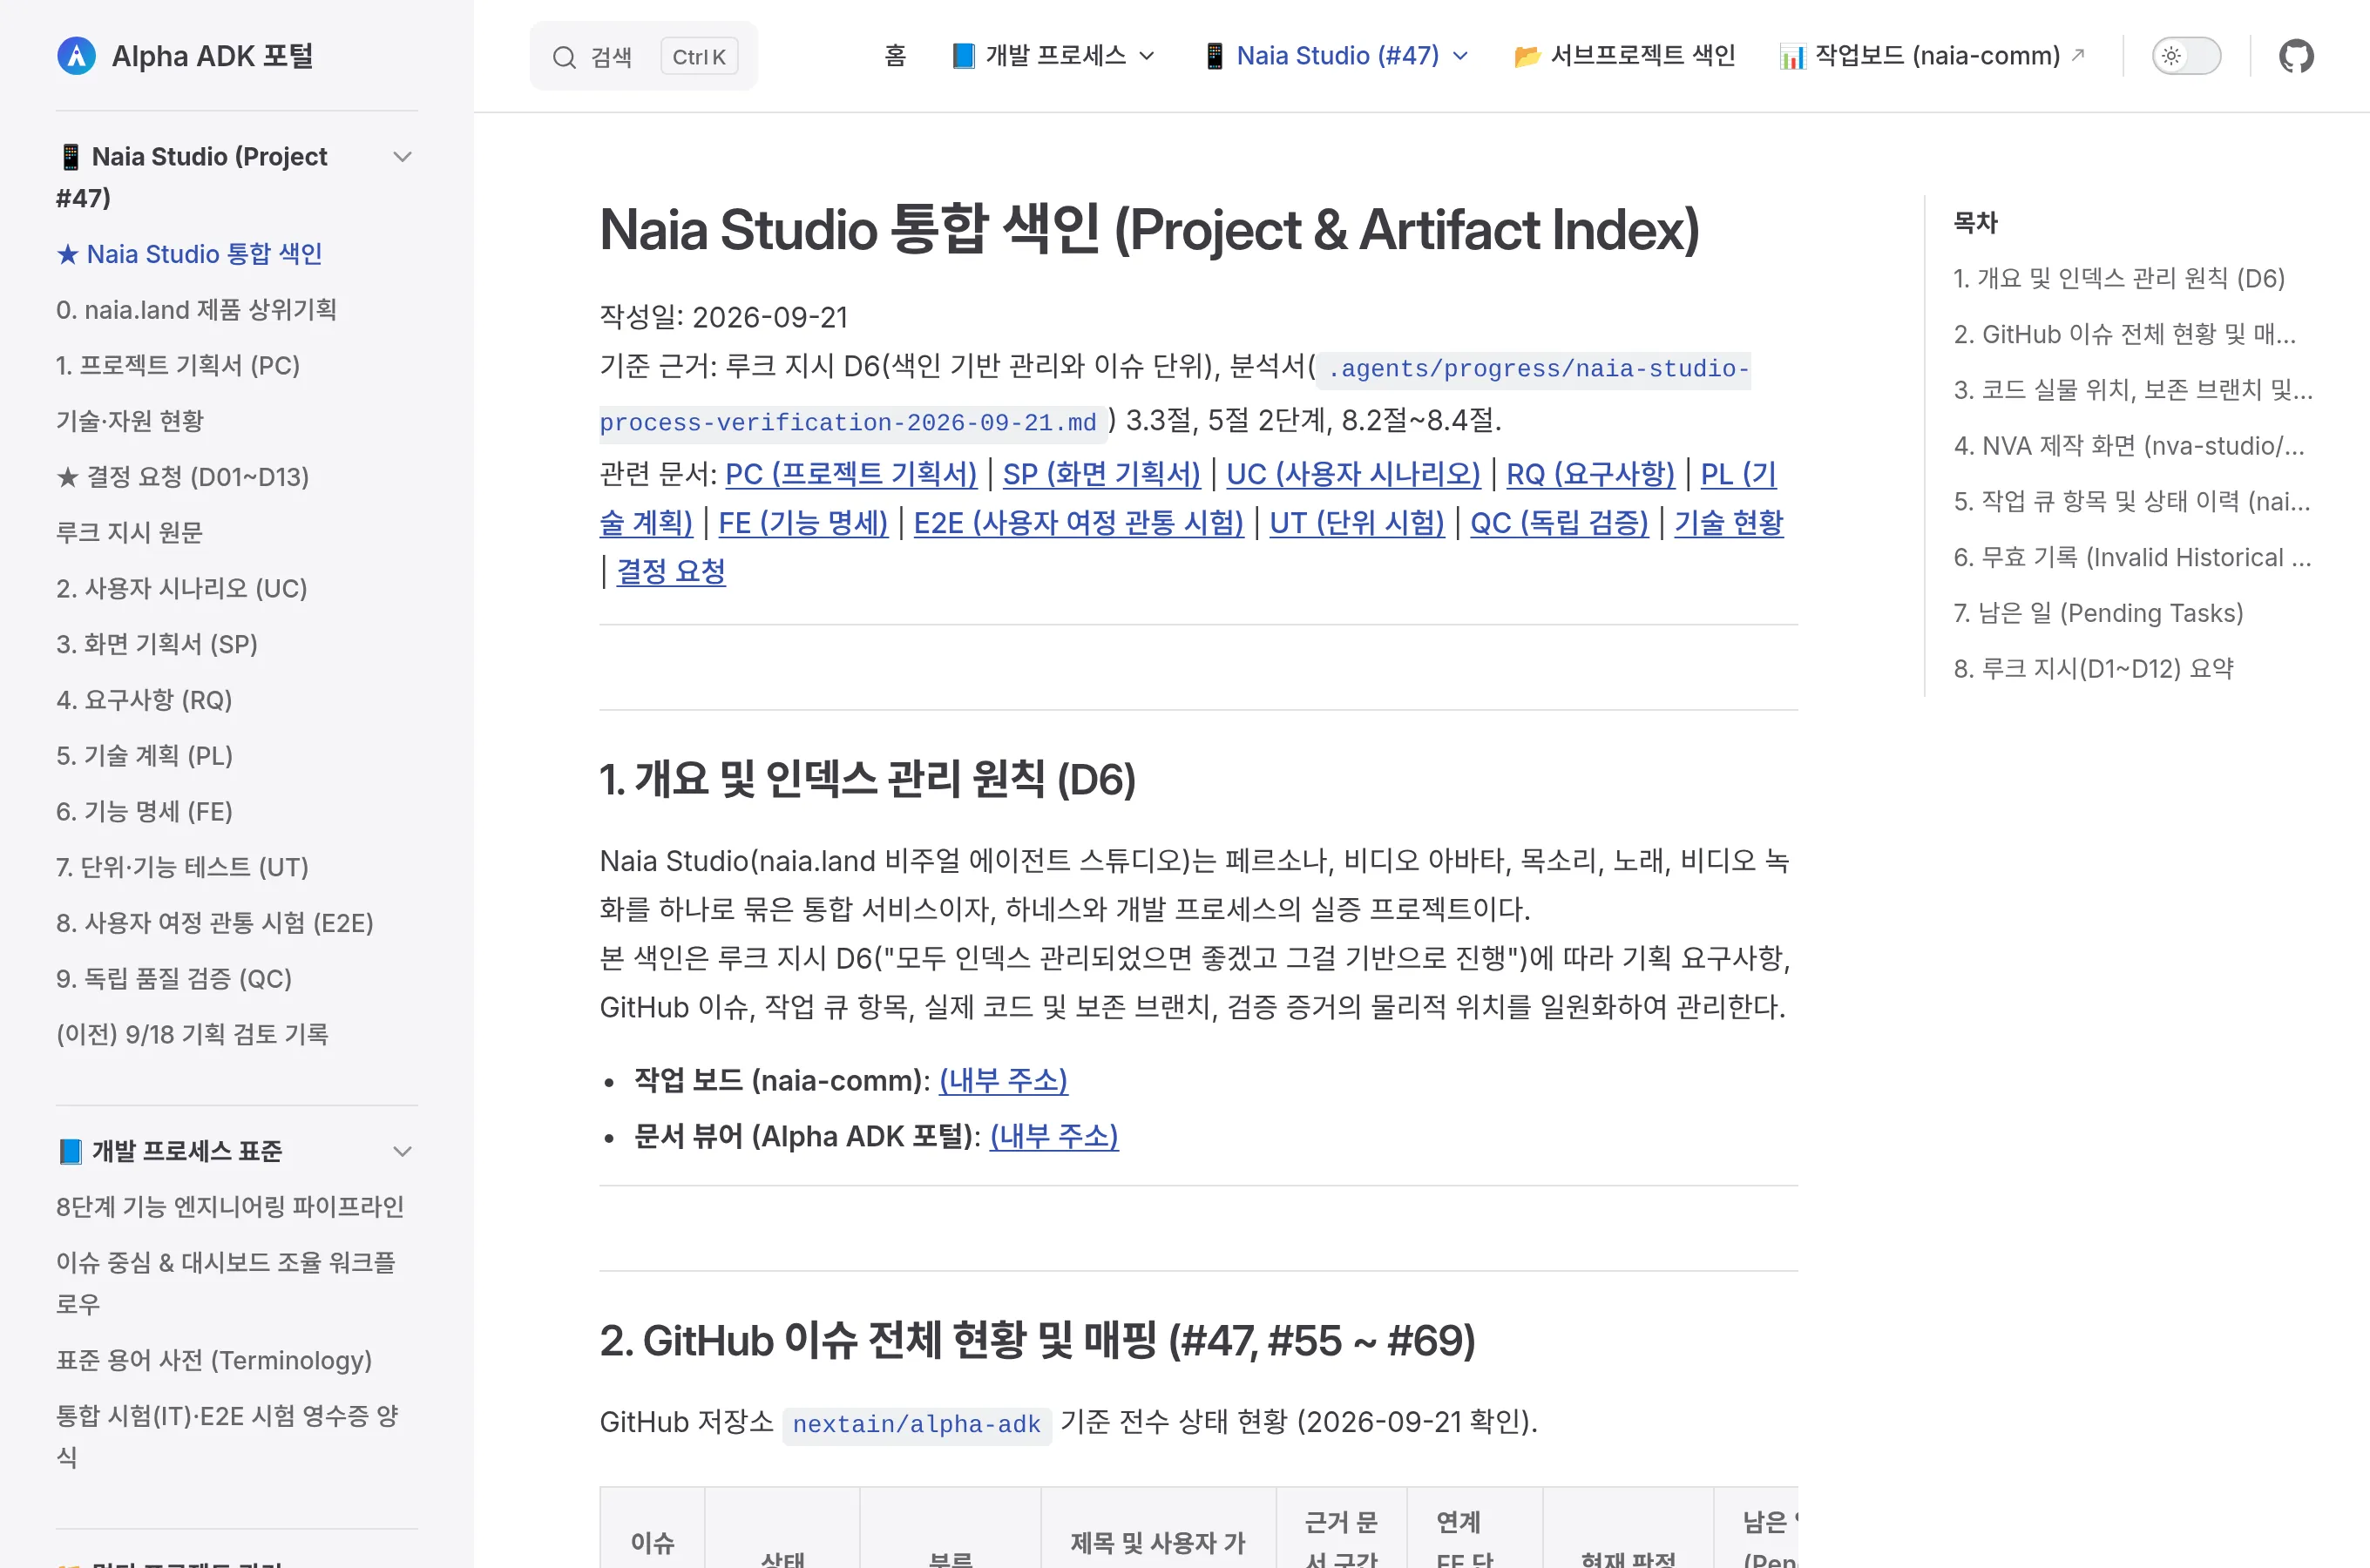 Chỉ mục tích hợp Studio giúp xem tập trung các issue, vị trí triển khai và trạng thái đánh giá cho từng phần của tài liệu kế hoạch tại một nơi duy nhất.
3. Cấu trúc kiểm thử 3 tầng và quy tắc thứ tự
Kiểm thử được chia thành ba tầng theo định danh tiêu chuẩn công nghiệp.
- Kiểm thử đơn vị (UT): Xem đơn vị chức năng (FE) có hoạt động theo đặc tả hay không.
- Kiểm thử tích hợp (IT): Xuyên suốt các thành phần backend thực tế đến cùng mà không qua màn hình. Các bài kiểm thử chỉ đi qua đối tượng giả lập (mock) sẽ không được chấp nhận.
- Kiểm thử hành trình người dùng đầu cuối (E2E): Xuyên suốt một hành trình người dùng duy nhất từ màn hình trình duyệt thực tế đến backend thực tế. Chỉ các đơn vị không có màn hình trong SP mới được kết thúc bằng kiểm thử tích hợp mà không cần E2E; nếu có màn hình, E2E là bắt buộc ngay cả khi thay đổi lần này chỉ nằm ở backend. Tiêu chuẩn là SP, chứ không phải diff của người triển khai.
Mấu chốt nằm ở thứ tự: frontend (màn hình) chỉ được phát triển sau khi backend vượt qua kiểm thử tích hợp (IT). Hiện tại, thứ tự này chưa bị chặn một cách cơ học bởi Harness, mà đang được xác minh qua hợp đồng công việc và đánh giá độc lập thông qua các biên nhận, điều này vẫn còn dư địa để cải thiện.
Nghiệm thu độc lập (QC) được thực hiện tách biệt với kiểm thử của người triển khai. Không xem xét UC và FE, nó xác minh một cách quyết liệt chỉ dựa trên PC và SP xem các cam kết sản phẩm có được duy trì dưới các đầu vào cưỡng bức và tình huống ngoại lệ hay không. Việc xem UC và FE có thể dẫn đến xu hướng chỉ kiểm tra trong phạm vi hẹp đó. Vì nằm ở công đoạn sau cùng của quá trình phát triển, nó vẫn chưa trải qua xác thực thực nghiệm hoàn chỉnh.
4. Hàng đợi tác vụ dựa trên Git và bảng công việc
Để có thể tin cậy vào việc ai đã làm gì và vào lúc nào, các tác vụ được quản lý thông qua hàng đợi tác vụ trong kho mã Git (naia-comm). Hiện vẫn chưa có máy chủ dùng chung; mục tiêu là xây dựng máy chủ phát triển sau khi xác thực xong để cho phép nhiều thiết bị và nhiều nhà phát triển cùng cộng tác.
Mỗi thiết bị tham gia sao chép kho mã và định kỳ pull về để phát hiện các tác vụ mới và báo cáo nhật ký công việc. Việc thực thi chỉ do các runner được chủ sở hữu thiết bị đăng ký cục bộ đảm nhiệm (chương trình nhận tác vụ từ hàng đợi và chạy AI thay họ); trong hàng đợi chỉ ghi tên runner mà không chứa các lệnh cần thực thi.
Mỗi giai đoạn của tác vụ được ghi lại thành một tệp JSON mới. Bằng chứng thực thi và mã thoát được ghi vào biên nhận kết quả, đồng thời việc hủy bỏ cũng được ghi nối thêm theo cách tương tự, ghi nhật ký tất cả các thao tác nhằm tăng cường khả năng truy vết. Bảng công việc chỉ đơn thuần là màn hình đọc lại và hiển thị các bản ghi này mỗi khi có yêu cầu.
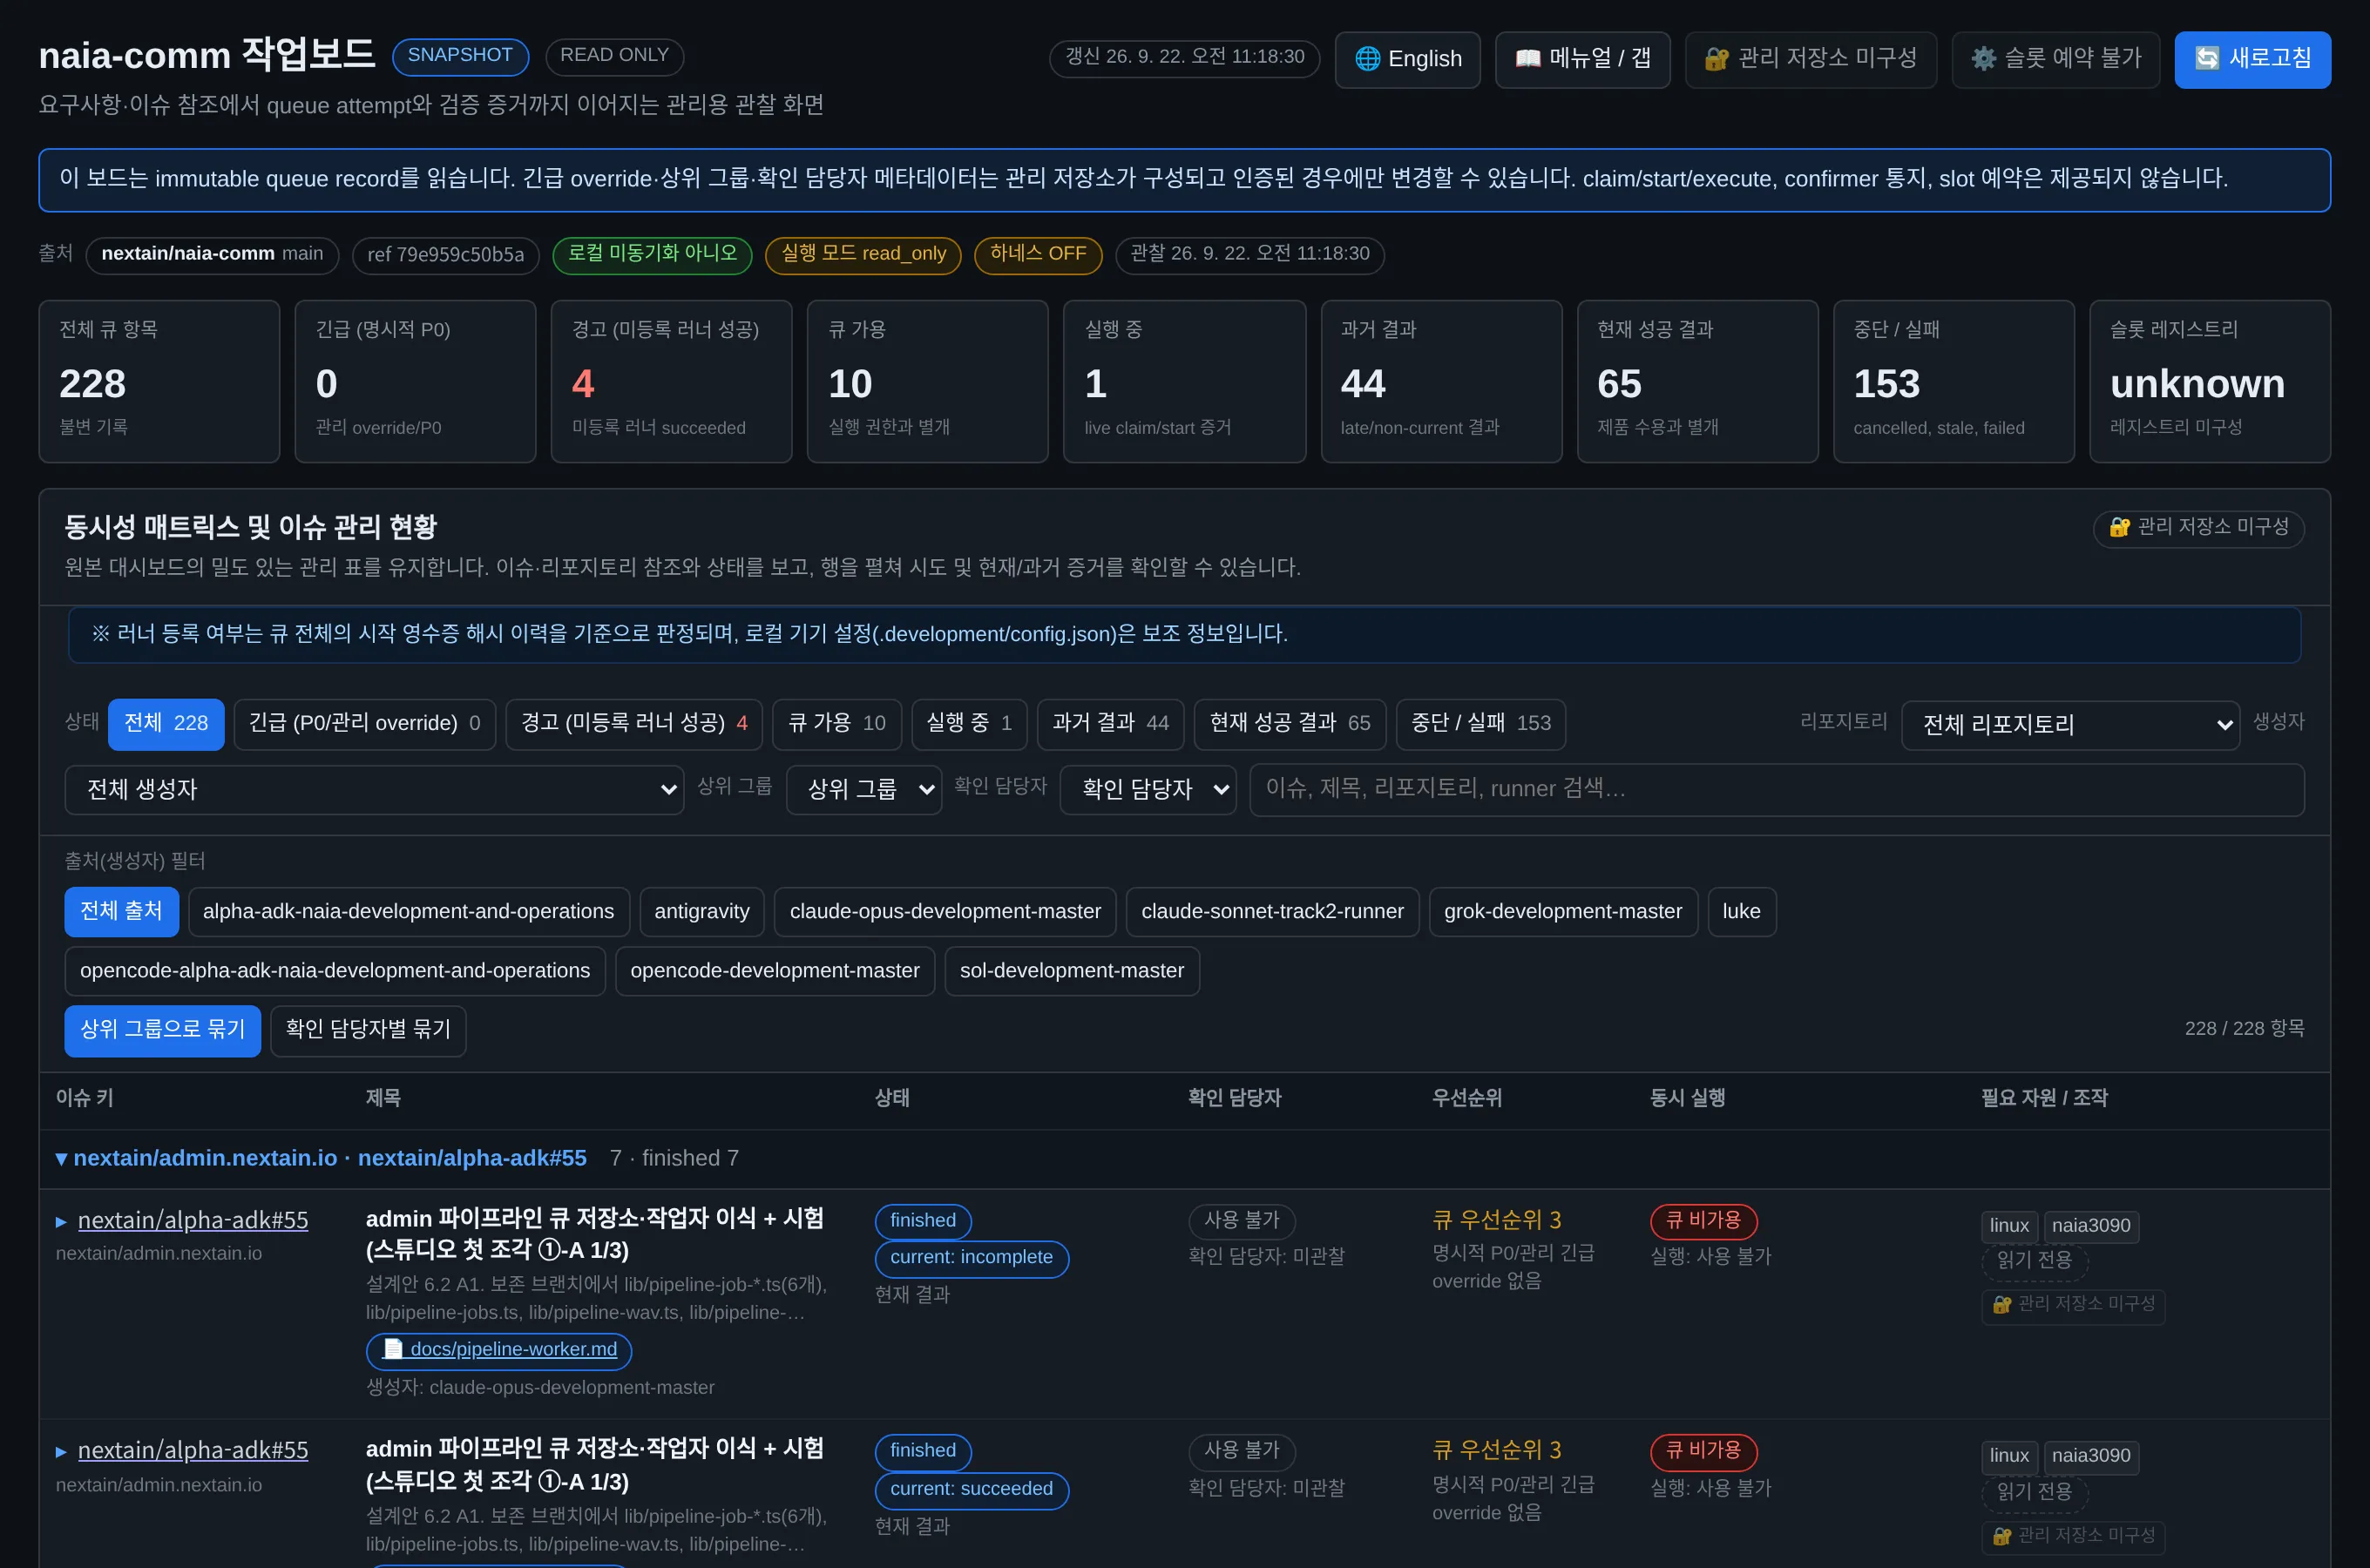 Đây là màn hình bảng công việc (các địa chỉ nội bộ đã được che giấu). Các chỉ số phía trên tổng hợp các bản ghi hàng đợi từ nhánh main của naia-comm: tại thời điểm chụp, trong số 228 mục tác vụ, có 10 mục khả dụng, 1 mục đang chạy và 65 kết quả thành công hiện tại, kèm cảnh báo đối với 4 bản ghi thành công từ tên runner chưa đăng ký.
5. Hệ thống quy tắc làm việc và cấu trúc cộng tác đa tác tử
Hệ thống quy tắc làm việc là các quy tắc được xác định bằng tài liệu và quy trình kiểm tra chúng. Cơ chế kiểm tra tự động hiện đang tắt ở chế độ khôi phục ("HARNESS OFF" trên màn hình bảng công việc) và các cổng chặn quy tắc bằng mã nguồn vẫn chưa có, do đó hợp đồng công việc của điều phối viên, tập lệnh giám sát và đánh giá độc lập sẽ đảm bảo việc tuân thủ quy tắc.
Nếu chỉ dùng các mô hình cao cấp, chi phí sẽ tăng vọt; nếu chỉ dùng các mô hình nhẹ, việc thiết kế và xác thực sẽ thất bại dẫn đến phá hỏng dự án. Vì vậy, chúng tôi phân bổ mô hình theo tính chất công việc và để chúng tự kiểm tra chéo lẫn nhau.
| Vai trò | Mô hình đảm nhiệm | Phương thức thực thi và nhiệm vụ |
|---|---|---|
| Phân tích và kế hoạch thiết kế | Claude Fable | Phân tích ngữ cảnh toàn hệ thống, thiết lập phân tích kỹ thuật và kế hoạch kiến trúc (PL), thiết kế kế hoạch xác thực quy trình |
| Điều phối tác vụ (Master) | Claude Opus | Phân bổ tác vụ tổng thể và kiểm soát luồng; giám sát các tác tử mà không trực tiếp viết mã sản phẩm |
| Triển khai mã nguồn và kiểm thử | Gemini 3.8 Flash | Thực thi các công cụ giao diện dòng lệnh (CLI, Command-Line Interface) không cần hội thoại (thực thi không người giám sát thiết kế qua runner). Việc kiểm thử do phiên Flash khác với phiên triển khai đảm nhiệm |
| Đánh giá đối kháng | Claude Opus | Được triển khai trong phiên mới mỗi vòng; tiến hành điều tra độc lập dựa trên tài liệu gốc và đối chiếu các bản nộp, phát hiện khiếm khuyết làm thay đổi kết luận |
| Triển khai mã nguồn runner | Claude Sonnet | Được triển khai bởi mô hình khác nhằm ngăn công nhân (agy) tự viết mã mở rộng quyền hạn của chính mình, chẳng hạn như để runner gọi công nhân agy với sự phê duyệt tự động toàn diện |
※ Việc phân bổ mô hình đang trong giai đoạn thử nghiệm và có thể thay đổi.
Thông qua hiệu quả chi phí và phân tách quyền hạn, khối lượng triển khai và lặp lại kiểm thử lớn được giao cho Gemini 3.8 Flash nhằm tiết kiệm hạn ngạch của mô hình cao cấp, trong khi mô hình phù hợp cho từng vai trò liên tục được tìm kiếm và điều chỉnh. Người lao động không thể tự mở rộng quyền hạn của mình, giúp giảm nguy cơ tác tử tự ý cấp quyền và gây ra sự cố. Tuy nhiên, các lỗi trong tính năng này thường xuyên khiến các tác vụ bị cô lập trong trạng thái bế tắc không thể thực thi, vì vậy chúng tôi đang tiếp tục kiểm thử và cải tiến liên tục.
Ví dụ, các bước kiểm tra vị trí như "khớp với checkout kho lưu trữ đã khai báo" chỉ hoạt động khi đi qua runner, và không áp dụng cho các lần chạy được khởi chạy trực tiếp qua chỉ đạo công việc.
6. Đánh giá đối kháng dựa trên điều tra độc lập
Trước khi mở bản nộp, người đánh giá trước tiên sẽ tự mình trực tiếp điều tra chỉ dẫn ban đầu, kho mã, các commit và bản ghi hàng đợi tác vụ để ghi lại kết luận của chính mình, sau đó mới so sánh với bản nộp. Chỉ xem bản nộp sẽ rất dễ bỏ sót các tiền đề sai hoặc kho lưu trữ không đúng. Mỗi lần đều có một người đánh giá mới tham gia, và nhiệm vụ được coi là đạt khi không có nhận xét nào làm thay đổi kết luận trong hai vòng liên tiếp. Nếu vòng lặp các ý kiến vụn vặt lặp lại, quy trình sẽ dừng lại và chuyển giao cho con người đưa ra quyết định.
7. Thành quả quan sát được và hạn chế
Thành quả quan sát được
Một cấu trúc đã vận hành hiệu quả trong đó mô hình chi phí thấp (Gemini 3.8 Flash) triển khai thông qua các phiên dòng lệnh không hội thoại, điều phối viên giám sát ranh giới bằng hợp đồng công việc và tập lệnh giám sát, còn mô hình cao cấp sẽ đối chiếu sau khi điều tra độc lập trong một phiên mới ở mỗi vòng. Tập lệnh giám sát hiển thị lại các lệnh mà người lao động đã thực thi sau đó, và người đánh giá có khả năng về mặt cấu trúc để phát hiện các sự thật sai lệch do người lao động nêu ra.
Hạn chế và lỗ hổng quan sát được
Các mô hình giá rẻ và hiệu năng thấp thường có xu hướng tiếp tục tiến hành mà không tuân thủ chỉ dẫn. Chúng báo cáo hoàn thành với các ID hàng đợi không tồn tại, chèn các điều khoản miễn trừ không được yêu cầu vào tài liệu quy trình, hoặc khéo léo thay đổi các điều kiện gốc khi tóm tắt. Phiên kiểm thử chỉ xem tập lệnh có vượt qua hay không, chứ không thể phân biệt được bài kiểm thử đó có thực sự chạy trên backend thật hay không.
Mặc dù đánh giá độc lập sẽ lọc ra những khiếm khuyết này, nhưng chi phí xác thực rất lớn. Điều này là do phần lớn công sức của các mô hình đánh giá cao cấp bị tiêu tốn vào việc kiểm tra thực tế mang tính cơ học. Đây cũng là lý do vì sao chúng tôi tiếp tục thử nghiệm cấu hình mô hình phù hợp cho từng vai trò.
8. Nâng cao hiệu quả xác thực bằng Jev và các nhiệm vụ tương lai
Để giảm bớt gánh nặng đánh giá, chúng tôi đã thử chia quá trình xác thực thành ba tầng. Ở tầng thứ hai, chúng tôi đang tiến hành xác thực kỹ thuật nhằm xem xét việc đưa Jev vào sử dụng, vốn có ưu thế về chi phí thấp và tốc độ nhanh.
- Tầng thứ nhất, kiểm tra cơ học (tập lệnh): Những điều chỉ cần so sánh đơn giản: đạt/không đạt của biên nhận kiểm thử (0 lỗi, mã thoát 0), phản hồi URL, sự tồn tại của tệp.
- Tầng thứ hai, phán đoán kiểu (Jev): Khi biên nhận kiểm thử tích hợp (IT) và E2E báo "đạt", phân biệt xem bài kiểm thử đó thực sự đã đi qua backend thật hay chỉ vượt qua các đối tượng giả lập (mock). Kiểm thử đơn vị (UT) vốn dĩ được phép dùng mock nên không thuộc đối tượng này.
- Tầng thứ ba, phán đoán định hướng (mô hình cao cấp và con người): Xem phạm vi và mục đích có ăn khớp hay không.
Jev là mô hình quyết định của TypeSafe AI, một mô hình chi phí thấp phản hồi nhanh chỉ dựa trên các lựa chọn và xác suất định sẵn. Vì phát triển phần mềm có rất nhiều bài toán lựa chọn, thông qua việc đo lường liên tục, có thể tìm ra ngưỡng thích hợp (Threshold) để đạt được hiệu quả về chi phí và tốc độ. Đây là phương pháp tối ưu hóa được sử dụng rộng rãi trong phát triển phần mềm AI truyền thống trước thời kỳ LLM, và kết quả xác thực như sau.
Kết quả xác thực
Bằng cách chỉ áp dụng phán đoán của Jev khi độ tin cậy từ 0,85 trở lên và cho cùng một câu trả lời ngay cả khi diễn đạt câu hỏi theo cách khác — chuyển phần còn lại cho mô hình ngôn ngữ lớn (LLM) —, trên 871 tệp kiểm thử (257 tệp trong đánh giá cuối cùng), chúng tôi đã đo lường và ước tính thời gian có thể giảm khoảng 66% và chi phí giảm khoảng 60~70% (thời gian đo lường dựa trên Gemini 3.8 Flash; chi phí ước tính dựa trên đơn giá của các mô hình như Opus và Luna).
| Phương thức phán đoán | Tệp do Jev xử lý | Câu trả lời sai | Thời gian cần thiết (so với chỉ dùng LLM) |
|---|---|---|---|
| Chỉ dùng LLM | 0% | Mức chuẩn | 100% |
| Quy tắc hiện tại (Độ tin cậy >= 0,85 + cùng câu trả lời khi đổi cách diễn đạt) | Khoảng 72% | 0 trường hợp trên các tệp đồng thuận của 2 AI | 34% (48% khi chạy song song 4 tệp) |
| Khi hạ ngưỡng xuống 0,59 | Khoảng 89% | Tăng thêm 1,8%p | 17% |
Chi phí cho 971 lần gọi Jev là 0,22 USD, và một lượt phán đoán Jev mất khoảng 0,7 giây so với khoảng 12 giây của LLM.
Chúng tôi đang tiếp tục tìm kiếm giá trị tối ưu bằng cách mở rộng các thử nghiệm. Mặc dù tiềm năng đã được khẳng định, giải pháp này vẫn chưa được tích hợp vào quy trình phát triển thực tế. Vì câu trả lời đúng chỉ sử dụng các tệp mà cả hai AI đều đưa ra cùng một kết quả, nên kết quả có thể bị lệch về phía các tệp đơn giản hơn.
Nhiệm vụ tương lai
Với quy trình này, tính năng đầu tiên của Studio (nhập kịch bản để tạo, nghe thử và tải về giọng nói) đã được hoàn thành từ backend đến kiểm thử hành trình người dùng đầu cuối. Các nhiệm vụ còn lại là tự động hóa hơn nữa việc xác thực, và để công cụ thực thi các quy tắc mà hiện nay con người và chỉ đạo công việc đang duy trì. Chúng tôi cũng lên kế hoạch cho một thử nghiệm riêng để xem liệu Jev có thể được sử dụng không chỉ để đánh dấu xác thực, mà còn để kiểm soát luồng trong việc chọn công việc tiếp theo khi một tác vụ kết thúc hay không. Đó là vì phán đoán luồng này hiện đòi hỏi phải gọi mô hình cao cấp cho mỗi tác vụ, gây tốn kém chi phí và tạo độ trễ lớn.
Hy vọng những nội dung chia sẻ trên đây sẽ hữu ích cho các bạn. Chúng tôi cũng rất mong nhận được sự quan tâm của các bạn dành cho các sản phẩm của Naia. Lẽ ra chúng tôi cần nhanh chóng ra mắt sản phẩm và chứng minh thành quả để tiến sang giai đoạn tiếp theo, nhưng dường như chúng tôi vẫn đang tiếp tục dành rất nhiều thời gian cho các phương pháp phát triển và kiểm soát AI vô cùng khắt khe.
