Jevで効率化を試すNaia ADKのドキュメント駆動型マルチAI開発プロセス
 こんにちは。Naiaを開発しているルークです。
Naiaは一般ユーザーが利用するキャラクターエージェントのプロダクトのように見えますが、私の仕事の多くはソフトウェア開発であるため、そのための開発インフラ構築や企業クライアントのSW開発をNaiaの開発インフラを利用して進めています。以前、『ハーネスエンジニアリング:Re:ゼロから始めるAIソフトウェア工学』(韓国語版、英語版)という書籍を出版したことがありました。その後もAIエージェントベースの開発プロセスをより洗練させるために多くの努力を続けています。
本日は、Naiaの開発のために構築したSW開発プロセスと成果物を公開し、最近注目の決定モデルであるJevをこの開発プロセスへどのように導入しようとしているのかについて共有します。
私がこの開発プロセスで追求したかったのは、可視性、並列化、コスト最適化の3点です。
- 可視性 : 正しく開発が進んでいるか、モデルドリフトが発生した場合にどの段階で問題が起きたのかを把握したい。
- 並列化 : マルチエージェントに並列で作業を分担させ、開発速度を向上させます。
- コスト最適化 : コスト最適化されたモデルを利用します。Jevもその優れた選択肢となります。
作業規約体系(ハーネス)の基本フレームワークは、以下のオープンソースとして公開されています。
- 個人ワークスペースの基本枠組みと作業規約体系(ハーネス): nextain/naia-adk
- チーム・プロジェクト協業用の基本枠組み: nextain/naia-pj-adk
- コミュニティ参加案内: nextain/naia-comm-public
- JevはTypeSafe AIが公開した決定モデルです。
この記事で説明するタスクキュー、ボード、ランナー、企画文書はまだ内部開発中のため非公開です。現在このプロセスも検証段階として、NaiaのWebで公開予定の新機能であるリップシンクと歌唱が可能なビデオアバター、Naia Visual Agent Studioの開発に試験運用しています。非公開としているのは、チームプロジェクトとして共同利用するにはまだ十分に整備されていない状態だからであり、整理でき次第追加で公開していく予定です。
この記事と開発文書で使用する略語
まず、私たちの開発文書、イシュー、タスクキューでは以下の略語を使用しており、プロジェクトの標準用語辞書が存在します。AIに指示を出す際に長文を入力するのが煩わしく、用語の混同を避けるためです。
| 略語 | フルネーム | 用語 | 1行の意味 |
|---|---|---|---|
| PC | Product / Project Concept | 上位企画 | なぜ作るのか。プロダクトの本質・存在意義・ユーザー価値・全体情報構造 |
| SP | Screen Plan | 画面企画 | ユーザーが目にする画面の構造的設計図(レイアウト・配置・画面遷移) |
| UC | User Scenario | ユーザージャーニー(ユーザーシナリオ) | ユーザーがある状況で訪れ、目的を達成して離脱するまでの全行程 |
| RQ | Requirements | 要件定義 | UCとSPを満たすためにシステムが充足すべき条件と測定可能な受け入れ基準 |
| PL | Plan / Architecture | 技術分析および設計計画 | 技術的現実を実測で確認し、アーキテクチャと段階的実装計画を策定 |
| FE | FEature | 機能仕様 | UCとRQを実現するために何を作るかという具体的機能単位。フロントエンド(Frontend)ではない |
| UT | Unit Test | 単体テスト | 機能単位が仕様どおりに動作するかを検証 |
| IT | Integration Test | 統合テスト | UIなしで実際のバックエンドコンポーネントを末端まで貫通するテスト。情報技術(IT)ではない |
| E2E | End-to-End Test | ユーザージャーニー貫通テスト | 実際の画面から実際のバックエンドまでユーザージャーニーを貫通するテスト |
| QC | Quality Control / Validation | 独立検収(独立敵対的妥当性確認) | 開発者のスクリプトや内部実装を見ず、PCとSPのみに基づいてプロダクトの約束を攻撃的に検証 |
1. 導入の背景と課題認識
AIエージェントに開発を大まかに任せると、バックエンドを作らずにユーザー画面(UI, User Interface)から作り始めたり、モックオブジェクトで実行したテストを合格として報告したりします。そのため、**企画は上から下へ(Top-down)、開発は下から上へ(Bottom-up)**進めます。企画は全体のユーザー体験からブレークダウンし、開発は動作する最小単位から積み上げますが、**バックエンドが実際に貫通した後に初めて画面を接続します。**画面から作ると統合時に大幅な手戻りが発生する可能性が高いためです。
2. ドキュメント駆動型ワークフローと開発プロセス
文書を先に書くのは、作成するスコープと受け入れ基準を事前に確定させるためです。指示事項を単なるプロンプトではなく文書化することで、問題発生時に原因を追跡できるようにするためです。
開発プロセスの文書をすべて一覧化し、人間の確認を経てからイシューとタスクキュー項目を作成します。AIは新規イシューを作成する前に、そのイシューがどの文書に関連しているかを確認し、過去に起票されたイシューも調査します。そうしてこそ、イシュー・キュー・テストレシートがすべて揃った状態でタスク完了を判定できます。
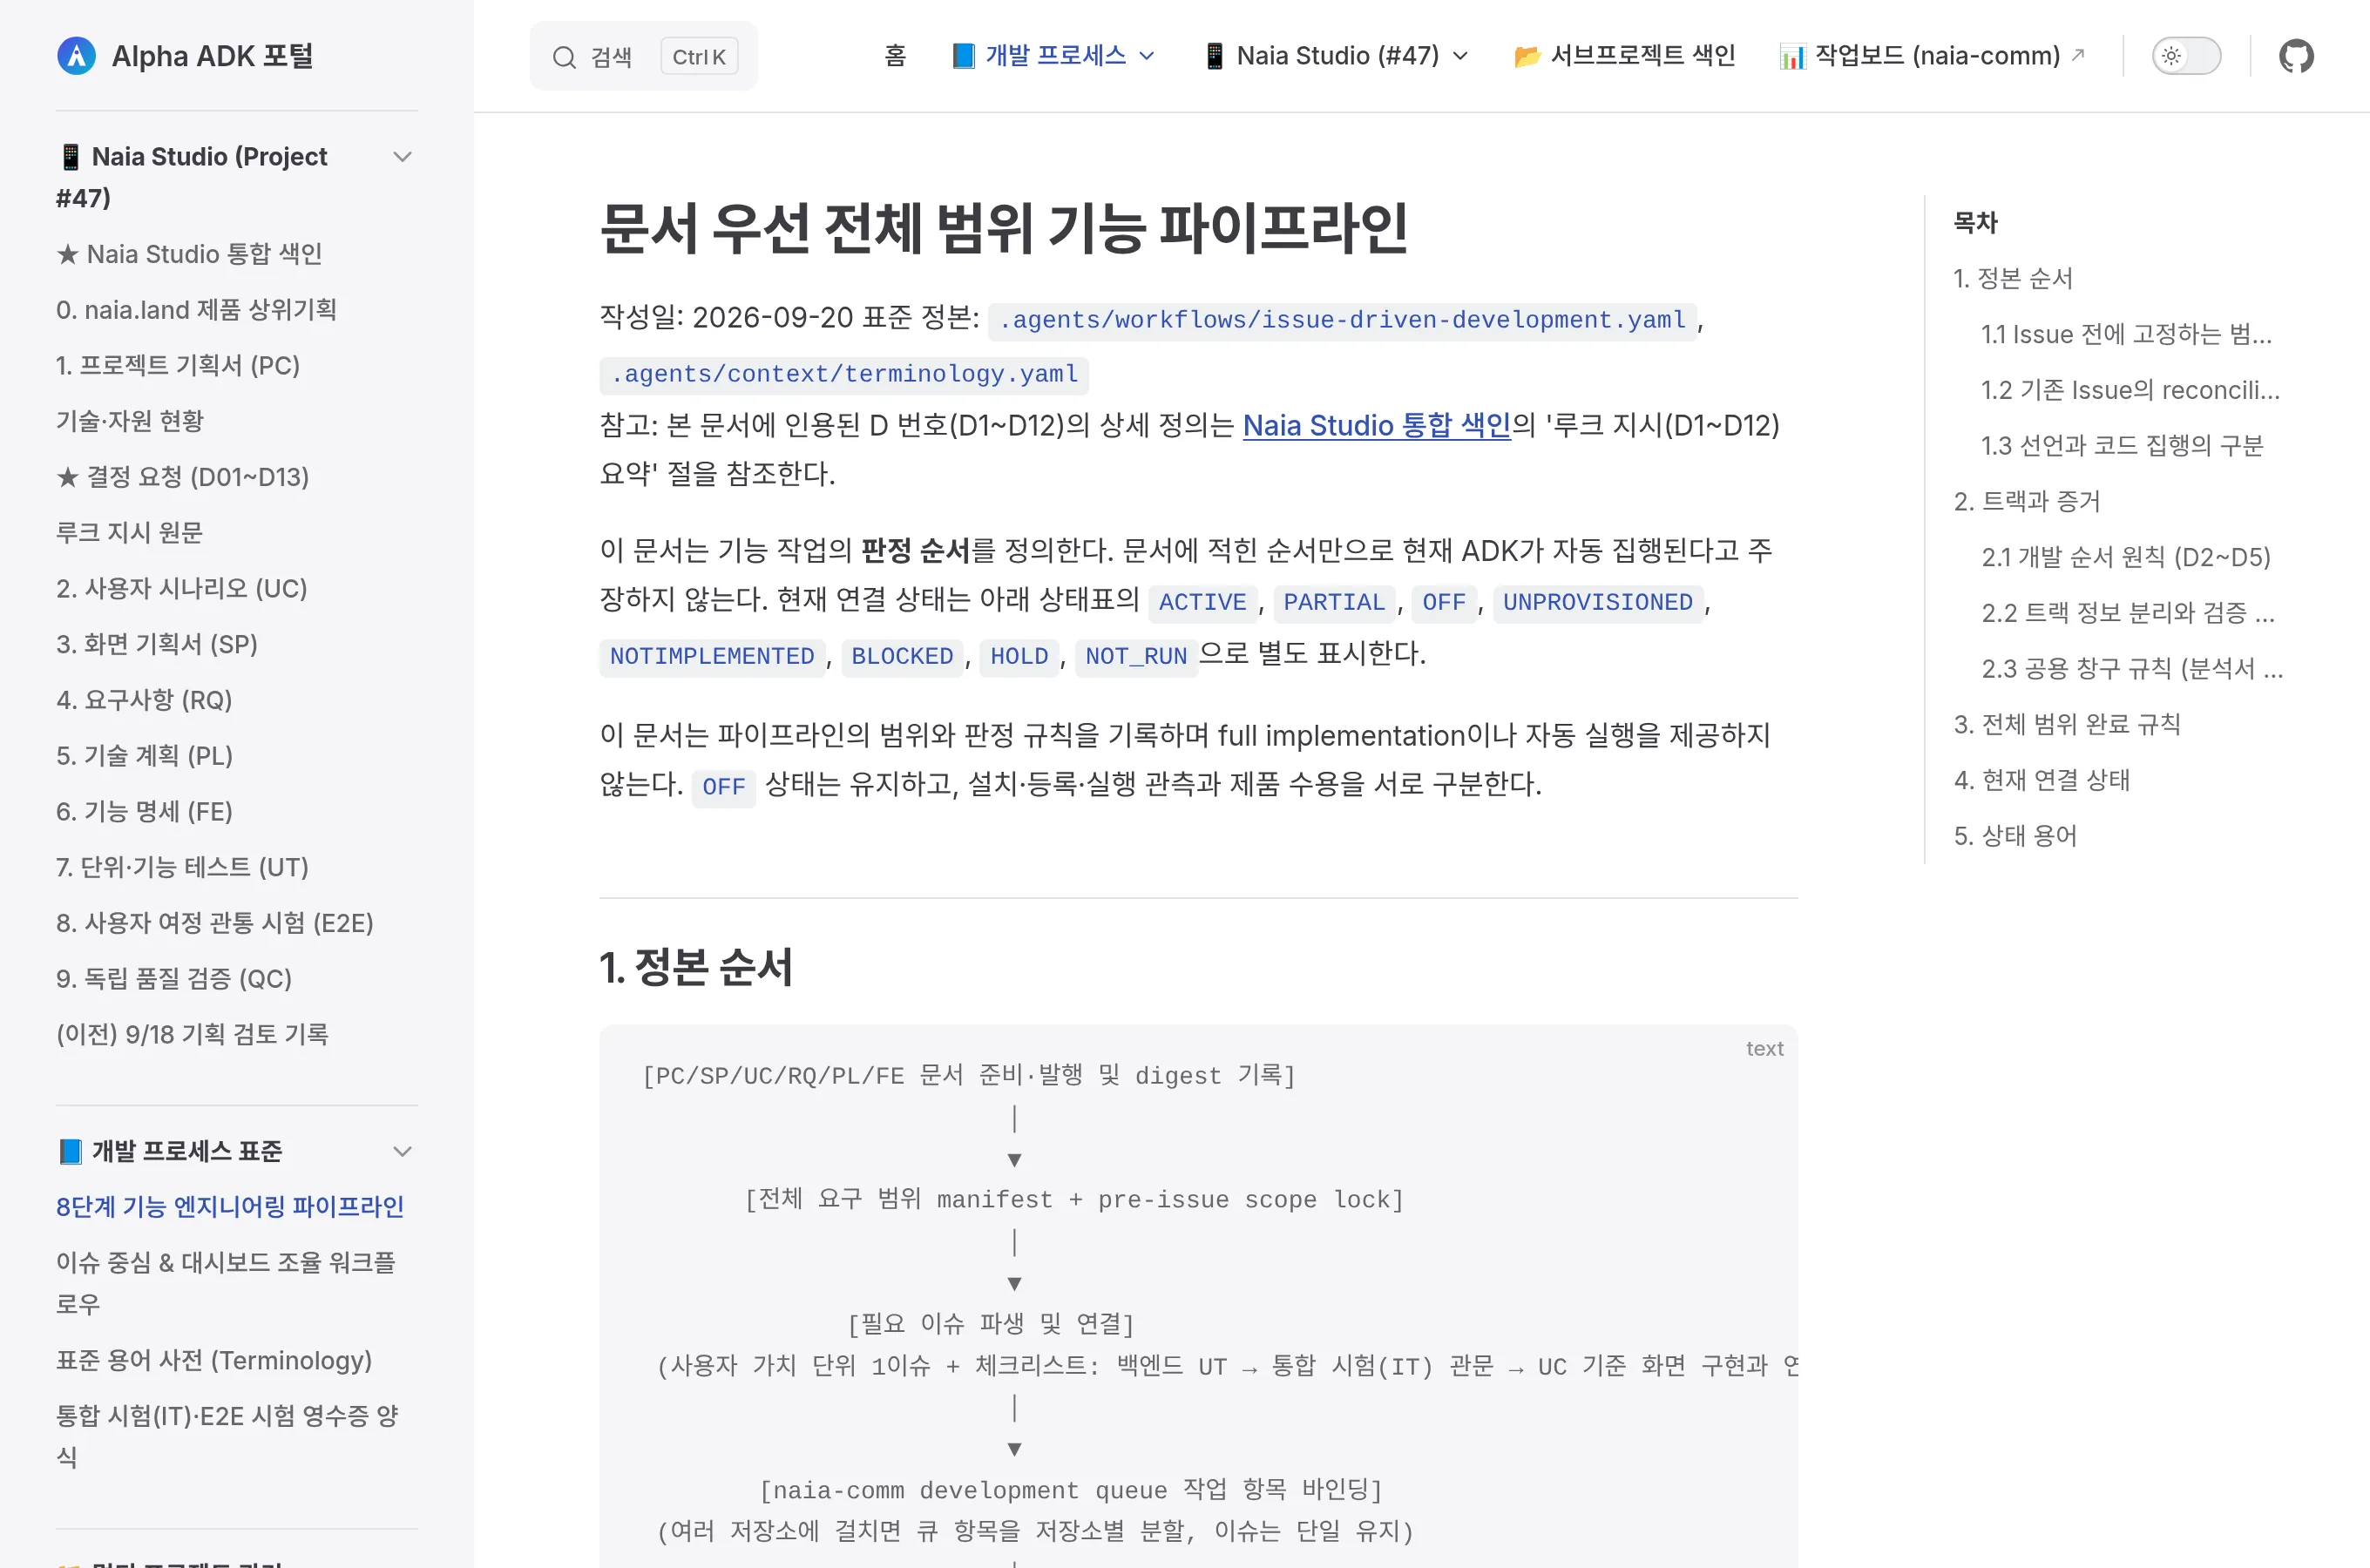 ドキュメントビューアの開発手順ページです。
文書は図の順序どおり、なぜ作るのか(PC)から作る機能単位(FE)へとブレークダウンし、設計(PL)はモデルやエンジンの限界を事前に実測した上で策定します。イシューは技術スタック層ごとに分割せず、ユーザー価値1つに対して1つのみ作成し、複数リポジトリにまたがる場合でも1つにまとめます。バックエンドから検収までの工程はそのイシュー内のチェックリストとして指定して漏れを防ぎ、完了判定は文書で固定された全スコープの証拠が揃った場合にのみ行います。
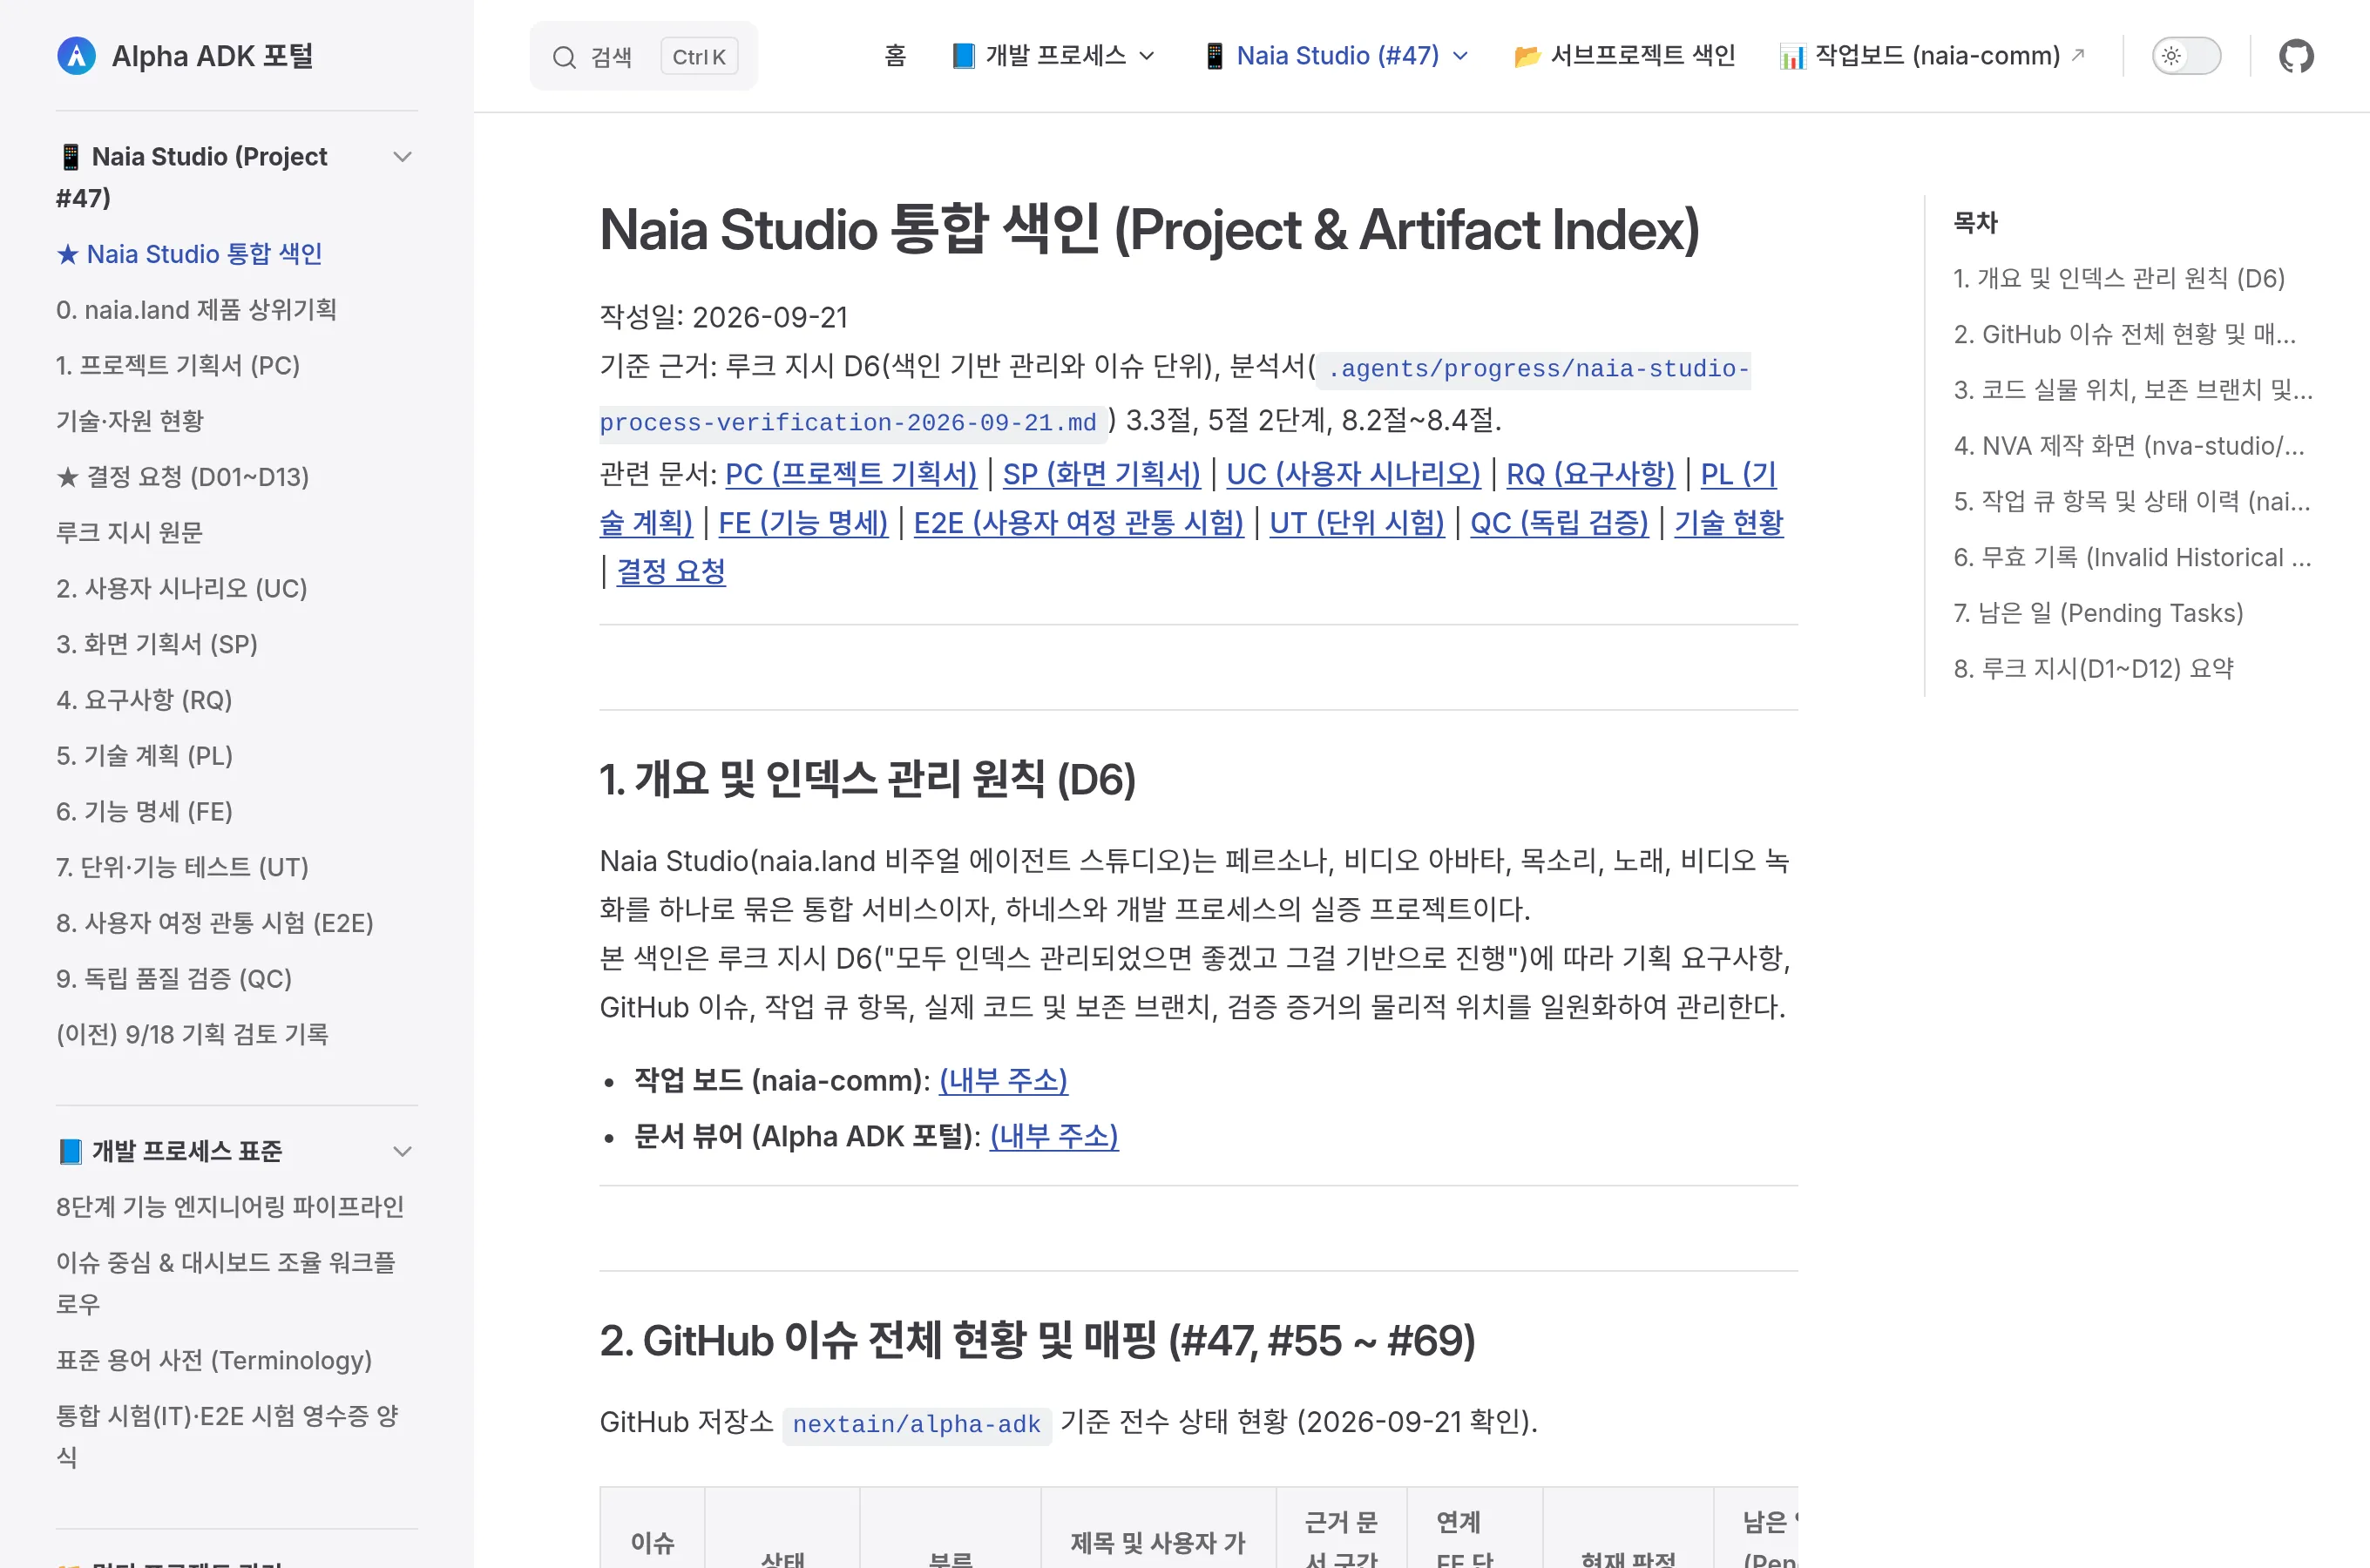 企画文書のセクションごとにイシュー、実装箇所、判定状況を一箇所で確認できるStudio統合インデックスです。
3. テストの3層構造と順序ルール
テストは業界標準の名称に従い3層に分類します。
- 単体テスト (UT): 機能単位(FE)が仕様どおりに動作するかを確認します。
- 統合テスト (IT): UIなしで実際のバックエンドコンポーネントを末端まで貫通します。モックオブジェクトのみを通過したテストは認められません。
- ユーザージャーニー貫通テスト (E2E): 実際のブラウザ画面から実際のバックエンドまで、1つのユーザージャーニーを貫通します。SPに画面が存在しない単位のみE2Eなしの統合テストでクローズし、画面が存在する場合は今回の変更がバックエンドのみであってもE2Eが必須となります。基準は実装者の差分ではなくSPです。
要となるのは順序です。バックエンドが統合テスト(IT)に合格した後にフロントエンド(画面)を開発します。現時点ではハーネスによってこの順序が機械的にブロックされているわけではなく、作業指示書と独立レビューがレシートを通じて確認している段階であり、改善の余地があります。
独立検収(QC)は実装者のテストとは切り離し、UCやFEを見ずにPCとSPのみに基づいて、意図的な不正入力や例外状況下でプロダクトの約束が守られているかを検証します。UCやFEを見てしまうと、その範囲内だけを確認しようとしてしまうためです。開発工程の後半に位置するため、現時点ではまだ実証検証には至っていません。
4. Gitベースのタスクキューと作業ボード
誰がいつ何を行ったかを信頼できるように、タスクはGitリポジトリ(naia-comm)のタスクキューで管理します。共有サーバーはまだ存在せず、検証完了後に開発サーバーを構築し、複数のデバイスや開発者が協業できるようにすることが目標です。
参加するデバイスごとにリポジトリをクローンし、定期的にプルして新規タスクを検出して作業ログを報告します。実行はデバイス所有者がローカルに登録したランナー(キューからタスクを受け取り、AIを代理実行するプログラム)のみが行い、キューにはランナー名のみが記録され、実行するコマンド自体は含まれません。
タスクの各段階は新しいJSONファイルとして作成されます。結果レシートには実行証拠と終了コードを記録し、キャンセルも追記する方式ですべての作業をロギングし、追跡性を高めています。作業ボードは、この記録をリクエストごとに再読み込みして表示するだけの画面です。
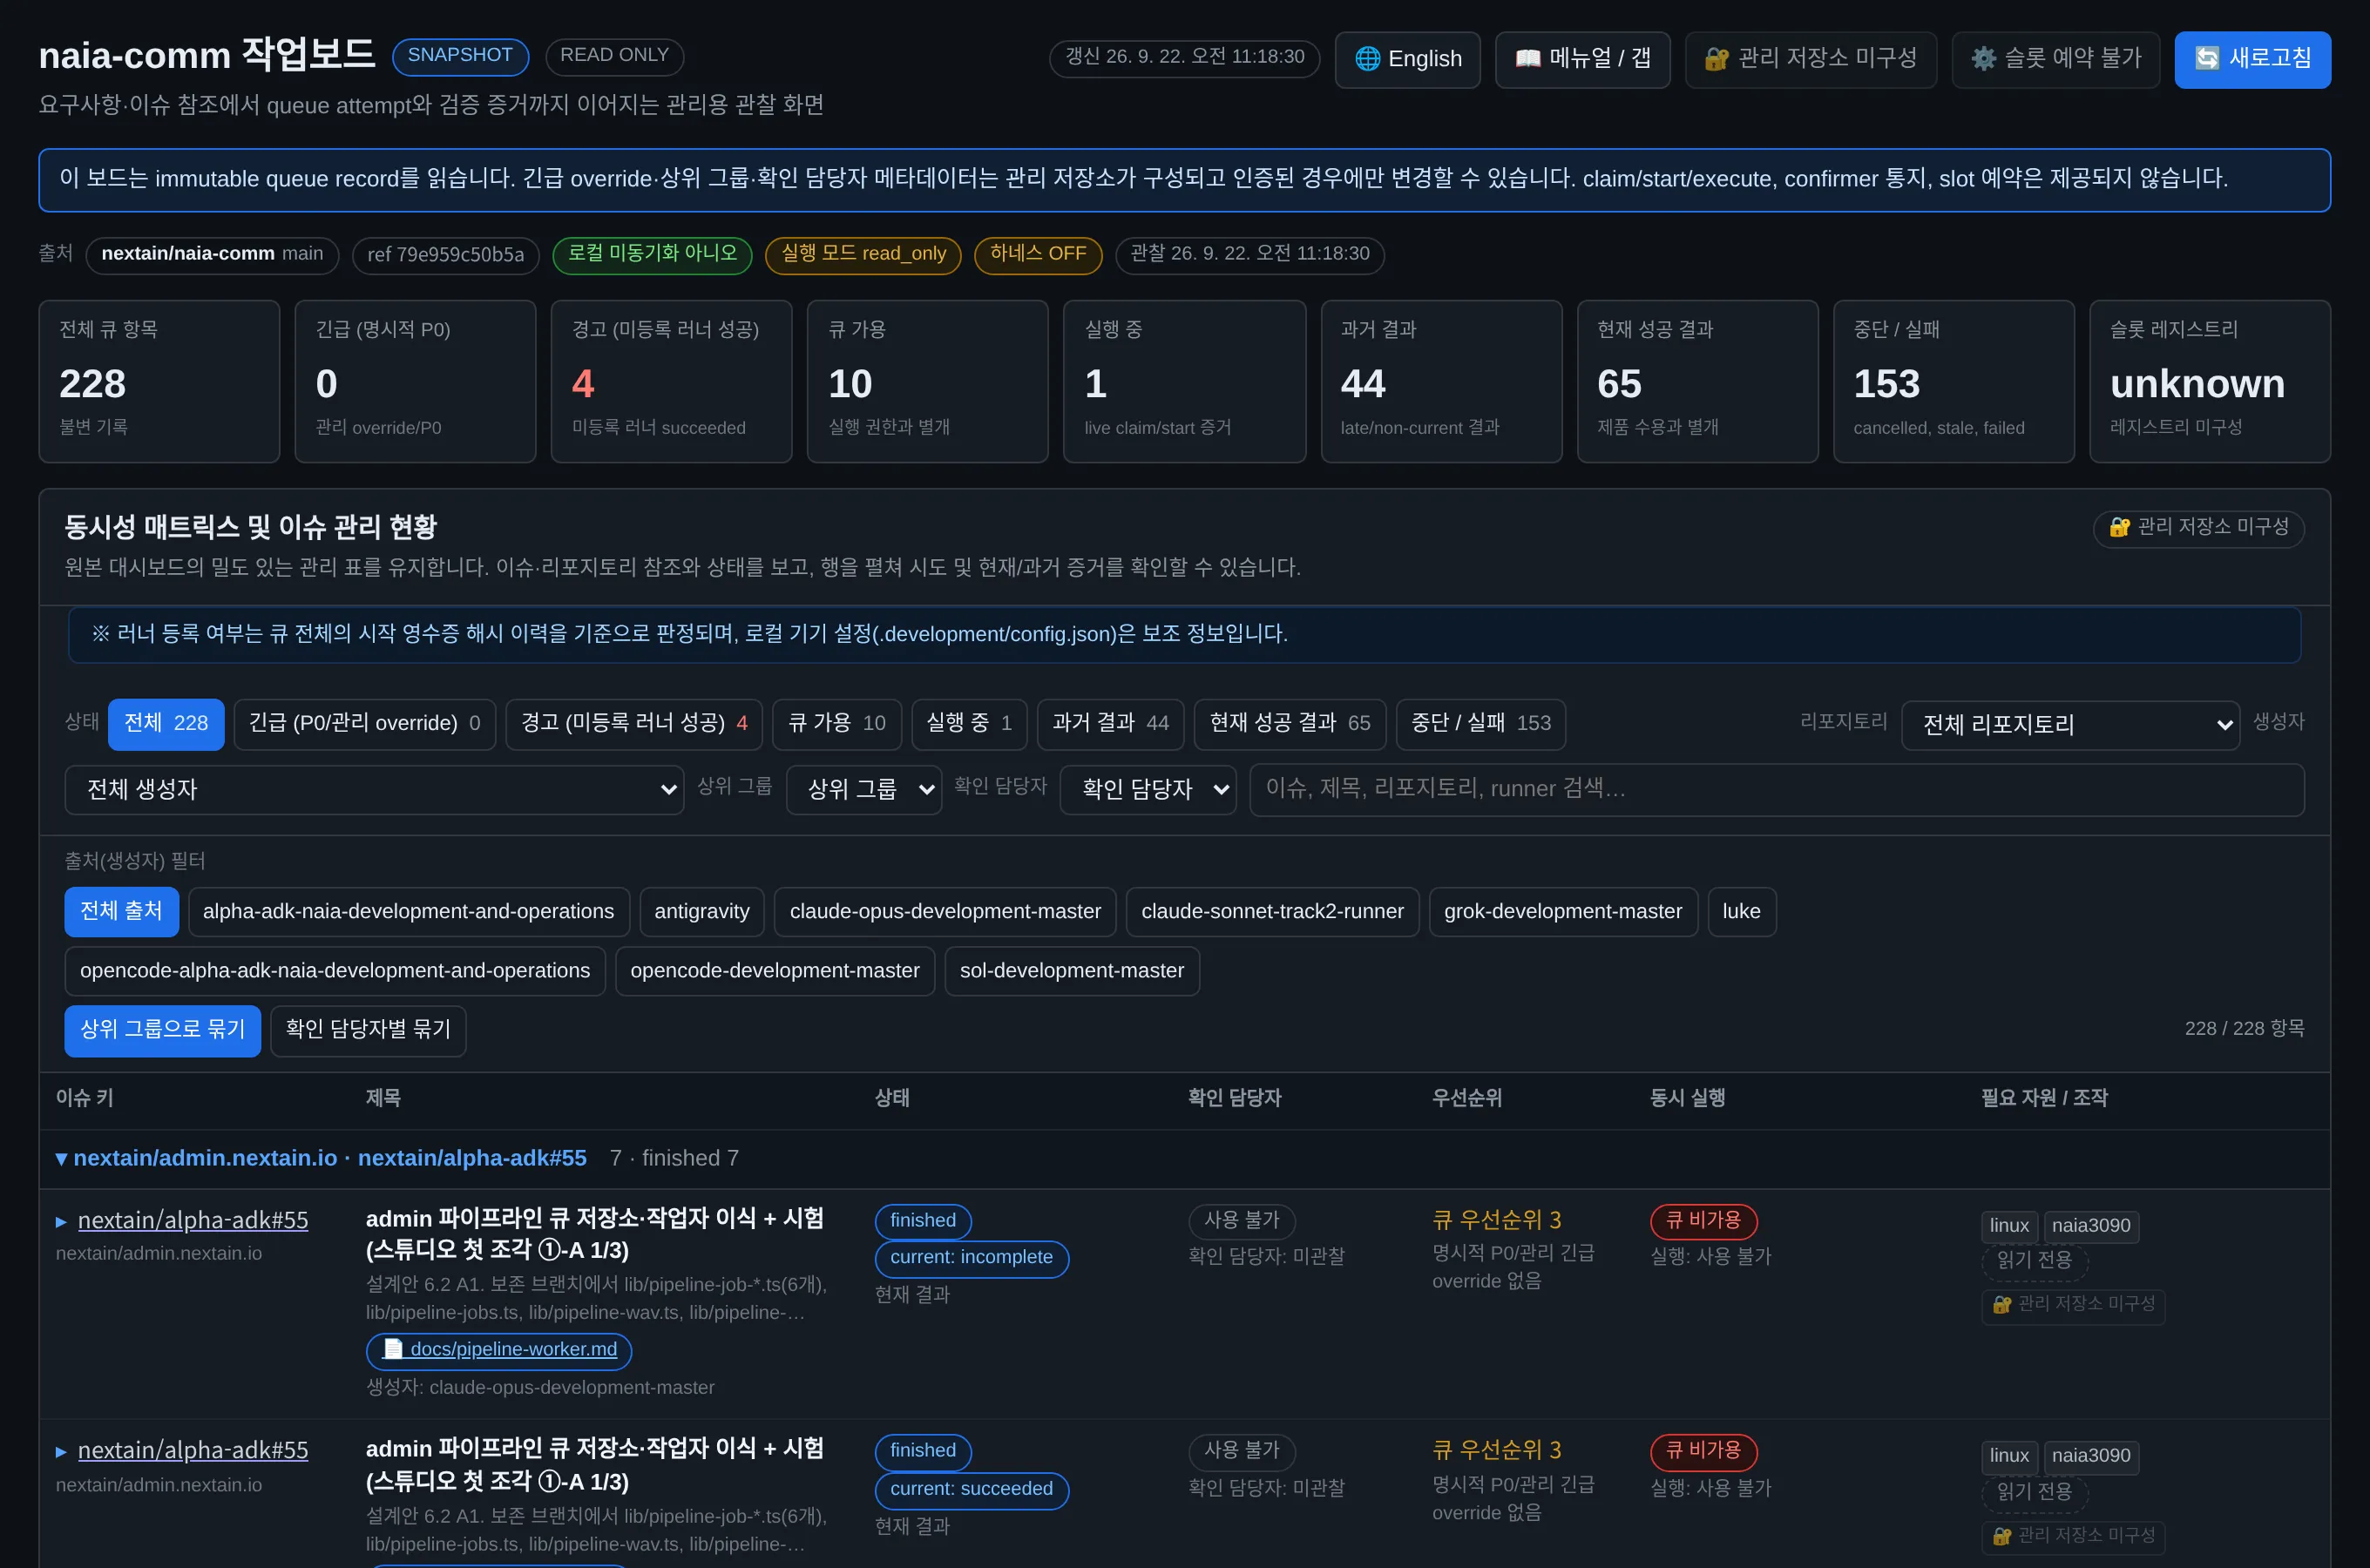 作業ボードの画面です(内部アドレスはマスクしています)。上部の指標はnaia-comm mainブランチのキュー記録を集計したもので、キャプチャ時点で228件のタスク項目のうち利用可能10件、実行中1件、現在の成功結果65件であり、未登録のランナー名で成功した記録4件に警告が表示されています。
5. 作業規約体系とマルチエージェント協業構造
作業規約体系とは、文書で定めたルールとその確認手順のことです。自動チェック機能は現在復旧モードとしてオフにしており(ボード画面の「HARNESS OFF」)、ルールをコードで遮断するゲートもまだ存在しないため、調整者の作業指示書、監視スクリプト、独立レビューによってルールを遵守させています。
上位モデルのみを使用するとコストが大幅に増大し、軽量モデルのみを使用すると設計や検証に失敗してプロジェクトが破綻します。そのため、作業の性質に応じてモデルを分散配置し、相互に検証させています。
| 役割 | 担当モデル | 実行方式および任務 |
|---|---|---|
| 分析および設計計画 | Claude Fable | システム全体のコンテキスト分析、技術分析および設計計画(PL)の策定、プロセス検証計画の設計 |
| タスク調整 (Master) | Claude Opus | 全体作業の配分とフロー制御、製品コードを直接記述せずエージェントを監視 |
| コード実装およびテスト | Gemini 3.8 Flash | コマンドラインツール(CLI, Command-Line Interface)を対話なしで実行(無人実行はランナー経由時の設計)。テストは実装とは異なるFlashセッションが担当 |
| 敵対的レビュー | Claude Opus | 毎ラウンド新しいセッションを投入、元資料に基づく独立調査および提出物の照合、結論を覆す欠陥の抽出 |
| ランナーコード実装 | Claude Sonnet | ランナーがagyワーカーを全面自動承認で呼び出すコードのように、ワーカー自身の権限を開放するコードはそのワーカー(agy)が書かないよう別モデルが実装 |
※ モデル配置は実験中であり、変更される可能性があります。
コスト効率と権限分離を通じて、分量の多い実装とテストの反復はGemini 3.8 Flashに任せることで上位モデルの利用枠を節約し、役割ごとに適したモデルを継続的に探索しています。ワーカーは自らの権限を自ら拡大できないため、エージェントが自己判断で権限を付与してトラブルを引き起こすリスクを低減しました。ただし、この機能の不具合によって進行不能状態に陥り停止するケースが多いため、継続的なテストと改善を行っています。
例えば「宣言されたリポジトリチェックアウトの一致」のような配置チェックはランナーを経由する場合にのみ機能し、作業指示書から直接起動された実行には適用されません。
6. 独立調査ベースの敵対的レビュー
レビュアーは提出物を開く前に、元の指示、リポジトリ、コミット、タスクキューの記録をまず自ら直接調査して独自の結論をまとめ、その後に提出物と照合します。提出物だけを見てしまうと、誤った前提や見当違いのリポジトリを見落とすリスクがあるためです。毎回新しいレビュアーが確認し、結論を覆す指摘が2回連続でなければ合格となります。軽微な指摘ループが繰り返される場合は停止し、人間にエスカレーションして判断を仰ぎます。
7. 観測された成果と限界
観測された成果
低コストモデル(Gemini 3.8 Flash)が非対話型コマンドラインセッションで実装し、調整者が作業指示書と監視スクリプトで境界を監視し、上位モデルが毎ラウンド新しいセッションで独立調査後に照合するという体制が機能しています。監視スクリプトはワーカーが実行したコマンドを事後表示し、レビュアーはワーカーが記述した誤った事実を捕捉できる構造になりました。
観測された限界と脆弱性
安価で性能の低いモデルは指示を守らずに作業を進めるケースが多く見られました。作成されていないキューIDを記載して完了報告を行ったり、指示にない免責条項を手順書に勝手に挿入したり、要約時に原文の条件を密かに改変したりします。テストセッションはスクリプトが成功したか否かのみを確認し、そのテストが実際のバックエンドに対して実行されたかどうかまでは判別できません。
このような欠陥は独立レビューによって検出されますが、検証コストが大きくなります。上位のレビューモデルの工数が機械的な事実確認に多く費やされるためです。これが、役割ごとに適したモデル構成を実験し続けている理由でもあります。
8. Jevを通じた検証効率化と今後の課題
レビューの負担を軽減するため、検証を3つの層に分割してみました。そのうち第2層に、低コストかつ高速な応答が強みであるJevの導入を検討すべく、技術検証を行っています。
- 第1層、機械的確認(スクリプト): テストレシートの成否(失敗0件、終了コード0)、URLレスポンス、ファイルの存在確認など、単純な照合で済むもの。
- 第2層、型判定(Jev): 統合テスト(IT)やE2Eレシートが「合格」となっている場合、そのテストが実際のバックエンドを経由したのか、それともモックのみを通過して合格したのかを判定します。単体テスト(UT)は本来モックを利用して良いため対象外です。
- 第3層、方向性判断(上位モデルと人間): スコープと意図が合致しているか。
JevはTypeSafe AIの決定モデルであり、あらかじめ定められた選択肢と確率のみで高速に応答する低コストモデルです。ソフトウェア開発には選択問題が多く、継続的な測定を通じて適切な閾値(Threshold)を見出すことで、コストと速度の効率化を達成できます。これはLLM以前の伝統的なAIソフトウェア開発で広く用いられていた最適化手法であり、検証結果は以下のとおりです。
検証結果
確信度が0.85以上であり、別の言い回しで質問しても同一の回答が得られた場合にのみJevの判定を採用し、それ以外は大規模言語モデル(LLM)に委譲する方式により、テストファイル871件(最終評価257件)において、時間は約66%、コストは約60〜70%削減できると測定・推定されました(時間はGemini 3.8 Flash基準、コストはOpusやLunaといったモデルの単価で計算した推定値)。
| 判定方式 | Jevが担当したファイル | 誤答 | 所要時間(LLMのみ使用時比) |
|---|---|---|---|
| LLMのみ使用 | 0% | 基準 | 100% |
| 現行ルール(確信度0.85以上+別表現でも同一回答) | 約72% | 2つのAI合意ファイルで0件 | 34%(4件ずつ並列実行時48%) |
| 閾値を0.59に引き下げた場合 | 約89% | 1.8%p増加 | 17% |
Jev呼び出し971回のコストは0.22ドルであり、1件の判定にかかる時間はJevが約0.7秒、LLMが約12秒でした。
最適な数値は実験範囲を広げながら継続して探索しています。**可能性は確認されましたが、まだ実際の開発プロセスには組み込まれていません。**正解データは2つのAIが同一の回答を出したもののみを採用したため、難易度の低いファイルに偏っている可能性があります。
今後の課題
この手順により、Studioの最初の機能(台本を入力して音声を生成・試聴・ダウンロードする機能)について、バックエンドからユーザージャーニー貫通テストまで完了しました。残された課題は、検証のさらなる自動化と、現在人間と指示書が遵守させているルールをツール側で強制できるようにすることです。また、Jevを検証の判定だけでなく、1つのタスクが完了した際に次に行う作業を選択するフロー制御にも活用できるか、別途実験を計画しています。このようなフロー判断はタスクごとに上位モデルを呼び出す必要があり、コストとレイテンシの大きな要因となっているためです。
共有した内容が皆様のお役に立てば幸いです。Naiaのプロダクトにもぜひご関心をお寄せください。プロダクトを迅速にリリースして成果を示してこそ次の段階に進めるのですが、気難しいAIの制御と開発手法について、引き続き多くの時間を費やしてしまっているように感じています。
